A modell, amely nem ír, csak dönt
Jev, Laya, Clef — és amit egy magyar, saját infrastruktúrán működő dokumentumfeldolgozó kezdhet velük.
Hányszor kérünk meg naponta egy 35 milliárd paraméteres nyelvi modellt arra, hogy válaszoljon egyetlen szóval? Bejövő vagy kimenő. Számla vagy szállítólevél. A számlakeresőt hívjuk, vagy a kintlévőségeket kérdezzük le?
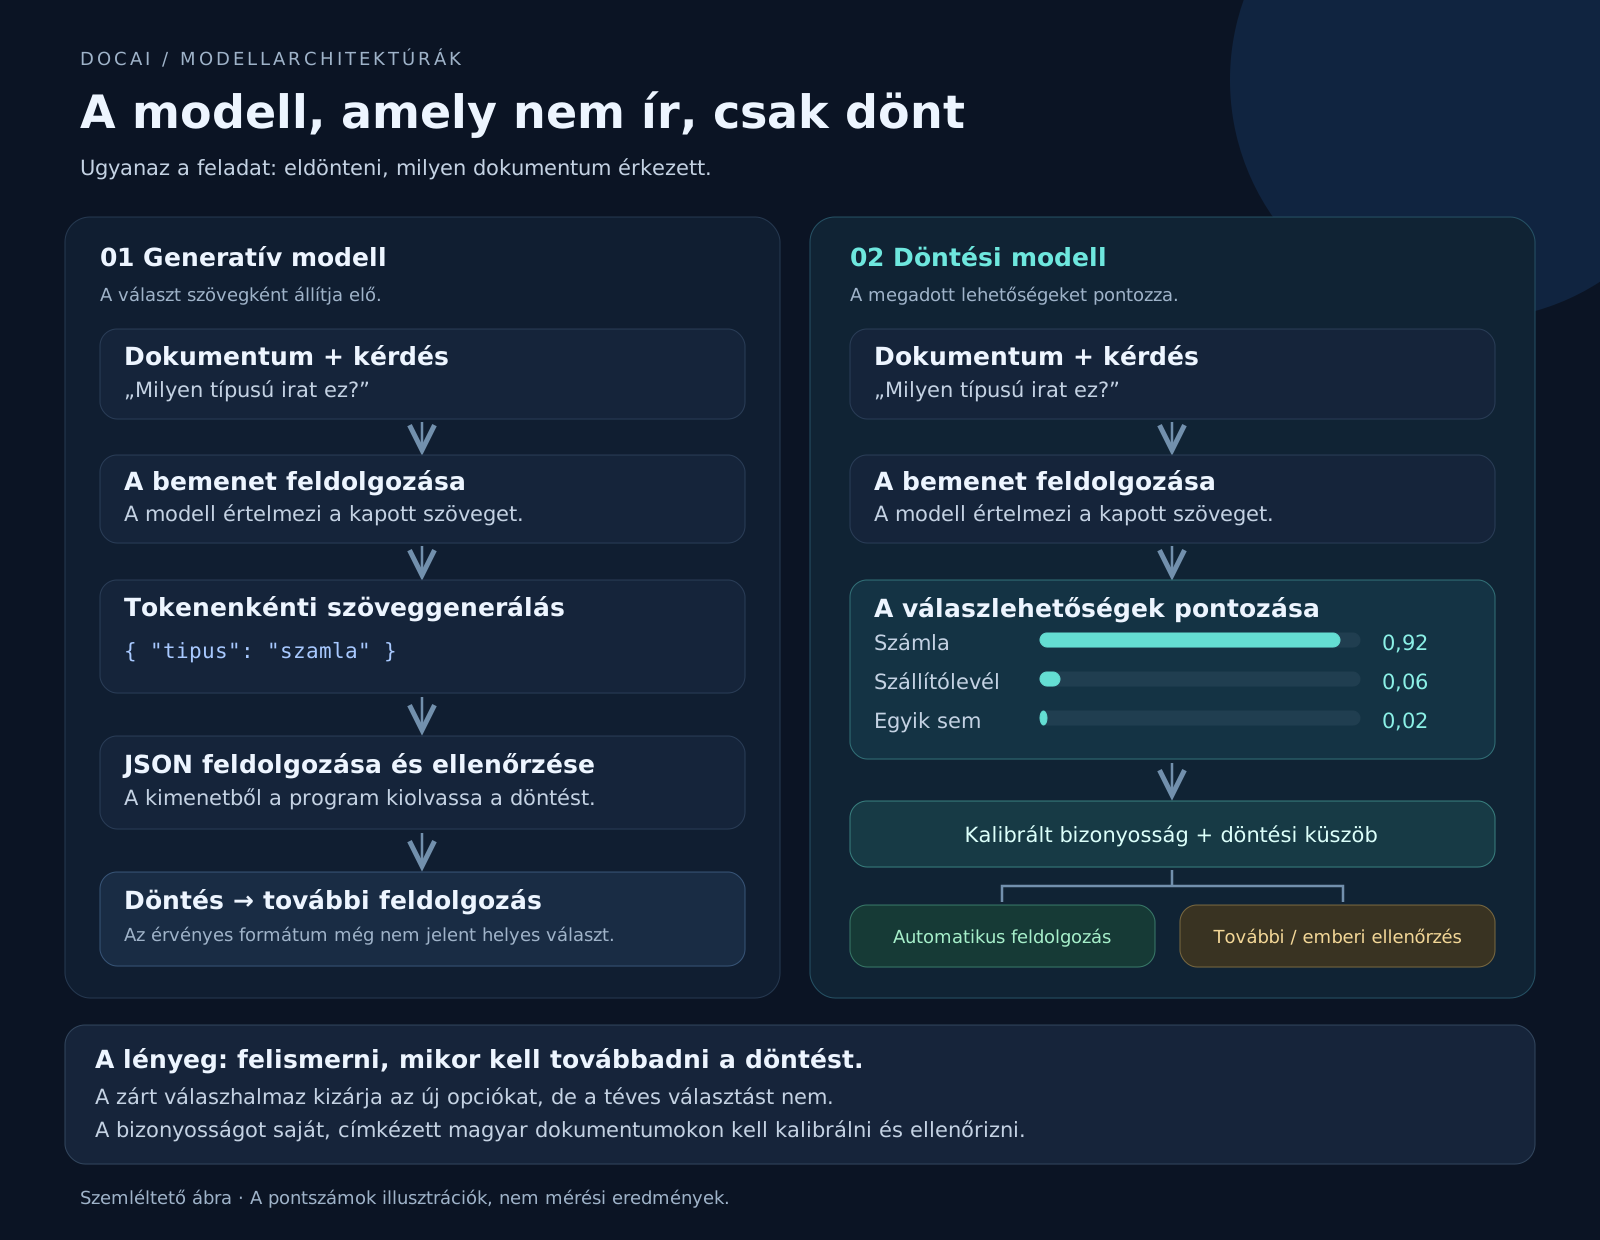
A modell ilyenkor is végigolvassa a bemenetet, majd tokenről tokenre előállít egy JSON-t. Mi ezt feldolgozzuk, ellenőrizzük, és a végén egy if feltételében használjuk fel. A teljes folyamat célja gyakran mindössze egyetlen döntés.
Szeptember közepe óta erre más megoldás is kínálkozik. Alig három hét alatt legalább három olyan modell jelent meg, amely egyáltalán nem generál szöveget. Megkapja az aktuális állapotot és az előre meghatározott kérdéseket, majd minden megengedett válaszhoz valószínűséget rendel. Ezek a döntési modellek. Az egyik fejlesztő System One modelleknek nevezi őket, Kahneman gyors, reflexszerű gondolkodásról alkotott fogalma nyomán.
Nálunk már elindult az ehhez kapcsolódó kutatás. Saját eredményeket még nem tudunk bemutatni, de azt igen, miért kezdtünk foglalkozni a témával. Ebben a cikkben végigvesszük, hogyan működnek ezek a modellek, mit ígérnek a fejlesztőik, és milyen korlátokról írnak a modellkártyák. Közben azt is megmutatjuk, hol lehet a helyük egy magyar, saját hardveren futó dokumentumfeldolgozóban.
Egyetlen szó, 35 milliárd paraméterrel
Egy dokumentum útját a DocAI-ban számos apró döntés kíséri. Milyen irat érkezett? Mi bocsátottuk ki, vagy nekünk szól? Melyik eszközt hívja meg a chat a felhasználó kérdéséhez? Ezekhez előre ismert lehetőségek közül kell választani.
A dokumentumtípusok besorolását nálunk ma egy XGBoost és egy logisztikus regressziós modell végzi, egymás mellett. Hét beágyazás összefűzött, 7 296 dimenziós vektorával dolgoznak. Ebben az összefoglaló, a cím, a fejléc, a lábléc, a témák és a szerkezeti ujjlenyomat mellett egy képi vektor is szerepel.
A besorolást szelektív predikció egészíti ki: ha a rendszer nem elég biztos a válaszban, az irat nem kap automatikusan típust. A „Nem beazonosított” szűrőbe kerül, ahol ember nézi át.
Ezzel a megoldással nagyjából 95%-os pontosságig jutottunk. A fennmaradó hibák azonban nem egyenletesen oszlanak el. A legkellemetlenebb tévesztések két, egymáshoz közeli dokumentumtípus határán jelentkeznek, ráadásul a modell ilyenkor gyakran magabiztos. Az irat átjut az ellenőrzésen, elkerüli a „Nem beazonosított” szűrőt, és észrevétlenül rossz helyre kerül.
Ezért nálunk a csendes félreosztályozások kiszűrése fontosabb, mint az automatikusan besorolt iratok arányának növelése. Egy diagnosztikai próba alapján a megkülönböztetéshez szükséges információ benne van a meglévő jellemzőkben. A jelenlegi modellek viszont nem használják ki elég jól.
Hasonló problémával a generatív modelleknél is találkoztunk.
Érvényes JSON, hibás döntés
Ha egy generatív modellre bízunk egy döntést, gyakran a kimenet formátuma miatt aggódunk. Betartja a sémát? Kitalál egy új mezőt? Megfelelő adattípust ad vissza?
A Llama-3.3-70B-vel végzett mérésünkben ez nem okozott gondot. Ahogy az „Amikor az eval hazudik” című cikkben is bemutattuk, mind a 119 kimenet érvényes JSON volt. Egyetlen formátumhiba sem akadt.
Közben a modell 108 mezőbe magabiztosan hibás értéket írt. A tévesztések éppen a partnerazonosításra és annak eldöntésére összpontosultak, hogy kihez tartozik a dokumentum. Vagyis arra a két mezőcsoportra, amelyre a további feldolgozás épül.
Ezt érdemes észben tartani, amikor a döntési modellek ígéreteit nézzük. Nálunk a költséges hibát a hihető, szabályos formátumú, mégis rossz válasz okozta. Olyan válasz, amelyről semmi nem jelezte, hogy kételkednünk kellene benne.
Három hét, három döntési modell
Jev: döntési szabályok a kódon belül
A TypeSafe AI modellje, a Jev 2026. szeptember 15-én jelent meg, korai hozzáféréssel. Diogo Almeida műhelyéből érkezett, aki korábban az OpenAI-nál a chatmodellek instrukciókövetési módszerein dolgozott.
A bejelentés szerint a Jev új architektúrát, párhuzamos mintavételezést és saját tanítási eljárást használ. Utóbbi neve Reinforcement Learning for Calibrated Decisions, röviden RLCD. A hívó előre megadja a lehetséges kimeneteket, a modell pedig ezekhez kalibrált valószínűséget és konfidenciát rendel.
Három kérdéstípust támogat: választást legfeljebb 255 opció közül (choice), sorrendi skálán történő értékelést (score), valamint igen/nem valószínűséget (noul). Az ára millió bemeneti tokenenként 0,042 dollár, a kimenetért nem kell fizetni. A teljes válaszidő a közölt adatok szerint 70–500 ms.
A TypeSafe „okos if-eknek” szánja ezeket a modelleket: olyan döntési szabályok helyére, ahol a kézzel megírt logika már túl törékeny. A Jev zárt API-n keresztül érhető el, a súlyait nem tették közzé.
Laya: kis enkóder, külön döntési fej
A Convai Innovations Laya modellcsaládja nyílt súlyokkal, Apache 2.0 licenc alatt érhető el. Három változata van: egy 421 millió paraméteres angol modell ModernBERT-large alapon, egy 322 milliós többnyelvű modell mmBERT-base alapon, valamint egy 421 milliós változat, amelyet négy konkrét munkafolyamatra finomhangoltak.
A többnyelvű modell felépítése jól követhető. A kétirányú enkóderhez egy nulláról tanított döntési fej kapcsolódik, két transformer-réteggel és egy opciónkénti pontozóval. Minden válaszlehetőség a saját [MASK] tokenjén kap pontszámot. Emellett külön fej dönti el, hogy a rendszer cselekedjen, vagy adja tovább a feladatot.
A lehetséges válaszokat így minden kérésnél újra meg lehet adni, a modell újratanítása nélkül. Egy kérdés feldolgozása T4-es GPU-n nagyjából 33 ms.
Clef: a nyelvi modell olvas, a döntési fej választ
A Cloudflare Clef és Clef-flash modelljei 2026. október 1-jén jelentek meg, szintén Apache 2.0 licenccel, a Jev API-jával kompatibilis felületen.
Számunkra elsősorban a felépítésük érdekes. A Clef egy befagyasztott Qwen3.8-27B-re, a Clef-flash egy befagyasztott Qwen3.5-9B-re épül. A Cloudflare a döntési fejet rank-256-os LoRA-adapterekkel együtt tanította, majd a kalibrációt külön Brier-veszteséggel finomította.
Futtatáskor a Qwen egyetlen prefill-menetben feldolgozza a bemenetet, ahogy azt szöveggenerálás előtt is tenné. Ezután a döntési fej párhuzamosan pontozza a lehetséges válaszokat. Szöveggenerálásra már nincs szükség.
| Jellemző | Jev | Laya (többnyelvű) | Clef / Clef-flash |
|---|---|---|---|
| Kiadó | TypeSafe AI | Convai Innovations | Cloudflare |
| Megjelenés | 2026. szeptember 15. | 2026. szeptember | 2026. október 1. |
| Súlyok | Zárt, csak API | Nyílt, Apache 2.0 | Nyílt, Apache 2.0 |
| Méret | A bejelentés nem közli | 322M | 27B / 9B |
| Alap | Saját architektúra | mmBERT-base + döntési fej | Befagyasztott Qwen + döntési fej + LoRA |
| Kontextus | 32k | 1 024 (8 192-ig bővíthető) | 64k |
| Bemenet | Szöveg | Szöveg | Szöveg és kép |
Ugyanarra a feladatra tehát három eltérő mérnöki megoldás született. A TypeSafe saját modellt épített, a Convai egy kis enkódert egészített ki döntési fejjel, a Cloudflare pedig egy meglévő nyelvi modellre épített, annak alapsúlyait változatlanul hagyva. A saját kutatásunkhoz ez utóbbi adta az ötletet.
Mit ígér a bemutató, és mit mond a modellkártya?
A döntési modellek bemutatóiban gyakran szerepel, hogy ezek a modellek nem hallucinálnak. A TypeSafe pontosítja is, mit ért ezen: mivel a lehetséges kimeneteket előre meghatározzuk, a modell nem találhat ki új opciót, és nem adhat vissza típushibás választ. Ezt a működése eleve kizárja.
A Llama mérésünk 108 hibás mezőjéből azonban a típusbiztonság egyet sem szűrt volna ki. Mindegyik rossz érték megfelelt az elvárt típusnak.
Nekünk ezért a kalibrált konfidencia a lényeges ígéret: hogy a válaszhoz kapott szám használhatóan jelezze a bizonytalanságot. Erre már építhető olyan küszöb, amely alatt a szoftver további ellenőrzést kér.
Hogy ez mennyire működik, azt mérni kell. A modellkártyák ebben sokat segítenek, mert a korlátokról is meglepően részletesen beszámolnak.
A kalibrációt a saját adatokon kell elvégezni
A Laya többnyelvű modelljének kártyája szerint a modell kalibrálatlanul érkezik. Rendszeresen túl magabiztos: az átlagos konfidenciája 0,75–0,83 között van, miközben a pontossága ennél jóval alacsonyabb.
Ha a hőmérsékleti paramétert saját, a tanítástól elkülönített adatokon, kérdéstípusonként és opciószámonként újraillesztik, az átlagos kalibrációs hiba (ECE) 0,314-ről 0,106-ra csökken. A használható valószínűségekhez tehát a saját adatokon végzett kalibráció is hozzátartozik.
A feladatra való felkészítés ugyanilyen fontos. A Laya zero-shot, vagyis külön finomhangolás nélkül 0,342-es pontosságot ér el a typed-decisions feladaton. A véletlen találgatás eredménye 0,318, a mindig a leggyakoribb választ adó stratégiáé pedig 0,461. A modellkártya egyértelműen leírja, hogy a döntési képesség a finomhangolásból származik. A Layára ezért gyors, specializálható alapként érdemes tekinteni.
A magabiztosság nyelvi kudarcot is elfedhet
Magyar fejlesztőként különösen tanulságos az angol változatról szóló rész. Más nyelveken a teljesítménye összeomolhat, miközben a modell továbbra is magabiztos marad. Khmer nyelven például 0,000-s pontosság mellett 0,952-es konfidenciát mutat. Az átlagos konfidenciája pedig egyetlen vizsgált pontossági szinten sem esik 0,885 alá.
Ezt pusztán egy konfidenciaküszöbbel nem lehet kiszűrni. A Convai ezért már a modellhívás előtt, a bemenet írásrendszere alapján választ nyelvi útvonalat. A modell saját bizonyossága ugyanis nem árulja el, ha nem tudja értelmezni a szöveget.
Ismerős probléma ez a már idézett eval-cikkből: kapunk egy értelmesnek látszó számot, amelyre könnyű volna ráépíteni a következő döntést. Csak éppen a szám nem azt jelzi, amit várunk tőle.
Az sem mindegy, mihez mérnek
A TypeSafe munkafolyamatokat vizsgáló tesztjeiben nincs kézzel címkézett referencia. Az elvárt válasz két nagy nyelvi modell, a GPT-6 Astra és a Fable 5.1 válaszainak átlaga.
A TypeSafe ezt maga is jelzi. Ahogy azt is, hogy a bemutatóban szereplő 193,6-szoros sebességelőny és 444,6-szoros költségelőny ezekből a munkafolyamatokból származik, és szerintük is a várható nyereség felső tartományát mutatja. A Cloudflare összehasonlító táblázata szintén saját futtatáson alapul.
Ezek a számok más modellekkel való egyetértést mérnek. Azt külön kell megvizsgálnunk, hogy egy magyar számlán mennyi helyes döntés születik.
Miért kezdtünk foglalkozni vele?
Három okból látunk lehetőséget ebben a modellcsaládban.
Az első a szelektív predikció. A dokumentumtípus-osztályozónk köré mi magunk építettük fel a kettős ellenőrzést és a „Nem beazonosított” szűrőt. A döntési modellek ezt a működést eleve támogatják: a válasz mellett valószínűséget és eszkalációs jelzést is adnak. Ha a kalibráció megbízható, a küszöböt üzleti szempontból is meg lehet határozni: mekkora hibaarányt fogadunk el az automatikusan feldolgozott iratoknál?
A második a helyben futtathatóság. Ügyfeleink magyar dokumentumai nálunk nem hagyják el a saját infrastruktúrát. A Jev zárt API-ja ezért kiesik, a nyílt súlyú Laya és Clef viszont ebből a szempontból is szóba jöhet.
A harmadik ok a Clef felépítése. Ez indította el a saját ötletünket: ha egy befagyasztott Qwen döntési fejjel és LoRA-adapterekkel ilyen feladatra is használható, vajon szükségünk van-e hozzá egy második, külön betöltött modellre?
A Sparkon, vLLM alatt már fut nálunk egy Qwen3.6-35B-A3B, amely naponta feldolgozza a dokumentumainkat. Azt szeretnénk kideríteni, kiegészíthető-e ugyanez a modell döntési fejjel, kis memóriatöbblet mellett, a feladatokhoz és az ügyfelekhez cserélhető LoRA-adaptereket használva. Az egyes ügyfelek iratköre eltérő; ügyfelenként egy adapter fenntartása kevesebb erőforrást igényelne, mint egy teljes modellé.
Egyelőre ez kutatási kérdés. Több lényeges részletre még nincs válaszunk.
A Cloudflare sűrű, azaz dense modellekre épített. A mi modellünk MoE, tokenenként nagyjából 3 milliárd aktív paraméterrel. Még nem tudjuk, hogy a szakértők közötti útválasztás mellett is ugyanolyan jól működik-e ez a megoldás.
A kiszolgálás szintén külön feladat. A vLLM-et generálásra optimalizálták, a döntési fej viszont a modell belső állapotaiból dolgozik. Meg kell oldanunk, hogyan férjen hozzá ezekhez a futtatás során.
A sebességet sem szeretnénk előre megbecsülni. Az eval-cikkben bemutatott sávszélesség-képlet a dekódolásra vonatkozott. Egy kizárólag prefillt végző döntési modellnél nincs ilyen ciklus, így a Sparkon más korlát válhat meghatározóvá. Hogy pontosan melyik, azt méréssel fogjuk eldönteni.
A mérési terv alapjai már megvannak. Három viszonyítási pontot használunk majd: a jelenlegi, kettős ellenőrzéssel működő osztályozónkat, a Clef-flash modellt zero-shot módban, valamint a generatív Qwent ugyanazzal a kérdéssel.
A fő mérőszám a szelektív pontosság adott lefedettség mellett lesz. Vagyis azt nézzük, hogy ha az iratok meghatározott hányadát automatikusan engedjük tovább, ezek között mennyi a hibás döntés. Emellett vizsgáljuk a magyar dokumentumokon mért kalibrációt, a válaszidőt és a memóriatöbbletet is.
Az is lehet, hogy egy kész, 9 milliárd paraméteres döntési modell bizonyul a jobb választásnak, és nincs értelme tovább bonyolítani a rendszert. Ezt ugyanúgy meg fogjuk írni.
Mielőtt konfidenciaküszöböt állítasz be
Akár Jevet, Layát, Clefet vagy saját modellt illesztenél a feldolgozási folyamatba, néhány ellenőrzést érdemes elvégezni. Az alábbi szempontok a modellkártyákból és a saját, sokáig észrevétlen hibáinkból adódnak.
- A saját nyelveden mérj. A Laya angol változata más nyelveken magabiztosan is kudarcot vallhat. Magyar szövegnél ezért határozd meg egyértelműen, melyik modellváltozat dolgozzon. Azt még nem mértük, hogy a Laya útválasztója hová küldi az ékezetes magyar szöveget.
- Vesd össze a konfidenciát a tényleges pontossággal. A saját, címkézett, tanítástól elkülönített adataidon csoportosítsd a válaszokat konfidenciasávokba: például 0,8 és 0,9 közé, illetve 0,9 fölé. Nézd meg, hogy az egyes sávokban a helyes válaszok aránya megfelel-e a jelzett bizonyosságnak. Ha a magas konfidenciához lényegesen alacsonyabb pontosság társul, a nyers értékre nem építhető megbízható küszöb.
- Kalibrálj a saját adataidon. A Laya modellkártyája szerint a kérdéstípusonként és opciószámonként újraillesztett hőmérséklet nagyjából harmadára csökkentette a kalibrációs hibát. Ez kis ráfordítással sokat javíthat a kapott valószínűségek használhatóságán.
- Nézd meg, mihez viszonyít a teszt. Ha a referencia egy másik modell válasza, a pontszám a két modell egyetértését mutatja. A tényleges helyesség megítéléséhez saját, ellenőrzött adatokra is szükség van.
- Legyen lehetőség továbbadni a döntést. Szerepeljen a válaszok között „egyik sem” opció, és legyen egyértelmű, mikor kerül emberhez a feladat. A szelektív predikció csak akkor használható, ha a bizonytalan esetek feldolgozásának is megvan a menete.
- A típusbiztonság mellett a helyességet is ellenőrizd. Egy szabályos, megengedett válasz is lehet téves.
Hol tartunk most?
A döntési modellekről ebben a cikkben még nem közöltünk saját mérést. Az idézett pontszámok, sebesség- és költségadatok mind a fejlesztők saját tesztjeiből és futtatásaiból származnak.
Egyelőre nem tudjuk, hogyan teljesítenek ezek a modellek magyar üzleti dokumentumokon, így rangsort sem állítunk fel közöttük. A saját fejlesztési irányunknál is a megválaszolandó kérdésig jutottunk el. Azt, hogy a megoldás működik-e, a következő mérések mutatják meg.
A következő lépés
Ahol szöveget kell írni, magyarázni vagy összefoglalni, ott továbbra is a generatív modellnek van feladata. A feldolgozás más pontjain viszont néhány ismert lehetőség közül kell választani, és a válasz után már egy if következik. Ezeknél a lépéseknél a döntési modellek közvetlenebb megoldást kínálnak. A kulcskérdés az, mennyire tudunk megbízni a választásukban és a hozzá adott bizonyosságban.
A következő cikkben a Clef-flasht mérjük meg magyar dokumentumokon. Utána a saját kísérletünk következik: döntési fej a már betöltött modellünkhöz. Ha az eredmény meggyőző, tanulmány lesz belőle. Ha nem, arról is írunk — csak valószínűleg rövidebben.
A döntési modellekről ebben a cikkben nincs saját mérés. A Jev adatai a TypeSafe bejelentéséből és API-dokumentációjából, a Laya adatai a Convai Innovations Hugging Face-modellkártyájáról, a Clef adatai a Cloudflare bejelentéséből származnak; ezeket nem reprodukáltuk. A Llama-3.3-70B-re vonatkozó számok (119-ből 119 érvényes JSON-kimenet, 108 hibás mezőérték) az „Amikor az eval hazudik” cikkben közölt mérésből valók: 100 valós magyar dokumentum, 119 kiértékelési egység. Az ábra szemléltető, a rajta szereplő pontszámok nem mérési eredmények.