Kínai szavak a magyar válaszban: mennyit szabad elvenni egy modellből, hogy elmúljon?
Egyetlen mátrix 55 424 sorát skáláztuk 0,9-től 0,1-ig, és megmértük, mibe kerül magyarul és kínaiul. A válasz két lépcső, köztük egyetlen használható dózissal, és egy ár, ami konstrukcióból nulla.
Van egy hibaosztály, amit nehéz komolyan venni, amíg nem a te rendszeredben történik: a modell magyarul dolgozik egy magyar iraton, majd a folyamat közepén kínai szavakat ír. Egy-két tokent, jellemzően kötőszót. Aztán visszatalál magyarra, mintha semmi nem történt volna.
Nálunk ez az éjszakai ügynöki hurokban jelent meg, magyar számlákon és szerződéseken, 0,6-os temperature-rel futó samplinggel. Ismert rá egy recept: a modell kimeneti mátrixában a kínai tokenek sorait le kell skálázni. Kipróbáltuk, működött. Ami hiányzott, az a szám: mennyit szabad elvenni, mibe kerül, és jó formájú-e a beavatkozás. Erre futott egy előregisztrált mérési kör: tizenkét modellváltozat, hat műszer, három nap. Ez a rövid változata; a hosszú, módszertannal és korlátokkal, a Kutatás rovatban van.
Két szó, mielőtt továbbmegyünk. A CJK a kínai, japán és koreai írás közös Unicode-tartománya, a Han pedig ezen belül a kínai írásjegyek neve. Han-kockázatnak azt a számot hívjuk, amely megmondja, hány Han-token várható egymillió generált pozíción. Nem a ténylegesen leírt kínai szavakat számolja, mert azokból túl kevés van a méréshez, hanem minden pozíción összeadja, mekkora valószínűséget adott a modell a Han-tokeneknek a sampling után. A jele /M. A nulla itt azt jelenti, hogy a kínai token egyetlen pozíción sem volt a választható jelöltek között.
Röviden:
- A dózis-hatás nem görbe, hanem két lépcső. A kínai képesség 0,7-es szorzóig érintetlen (36/36), 0,6-nál a felére esik, 0,5-nél gyakorlatilag eltűnik. A Han-kockázat 0,8-tól lefelé pontosan nulla, 0,9-nél még szivárog. Egy dózis van az ablakban: a 0,7.
- A magyar ár nulla, és nem szerencséből. A beavatkozás csak a kínai sorokhoz nyúl, azok magyar szövegen soha nem nyernek, ezért a foltozott változatok greedy magyar kimenete bájtra azonos az eredetivel 150 feladaton. A költség egésze a kínain van.
- A 0,7-es változat egyetlen Han-tokent sem generált ~1,09 millió pozíción, több kiszolgálón, több seeddel. Az eredeti modell ugyanezeken a futásokon több ezret.
Hol avatkoztunk be, és miért ott
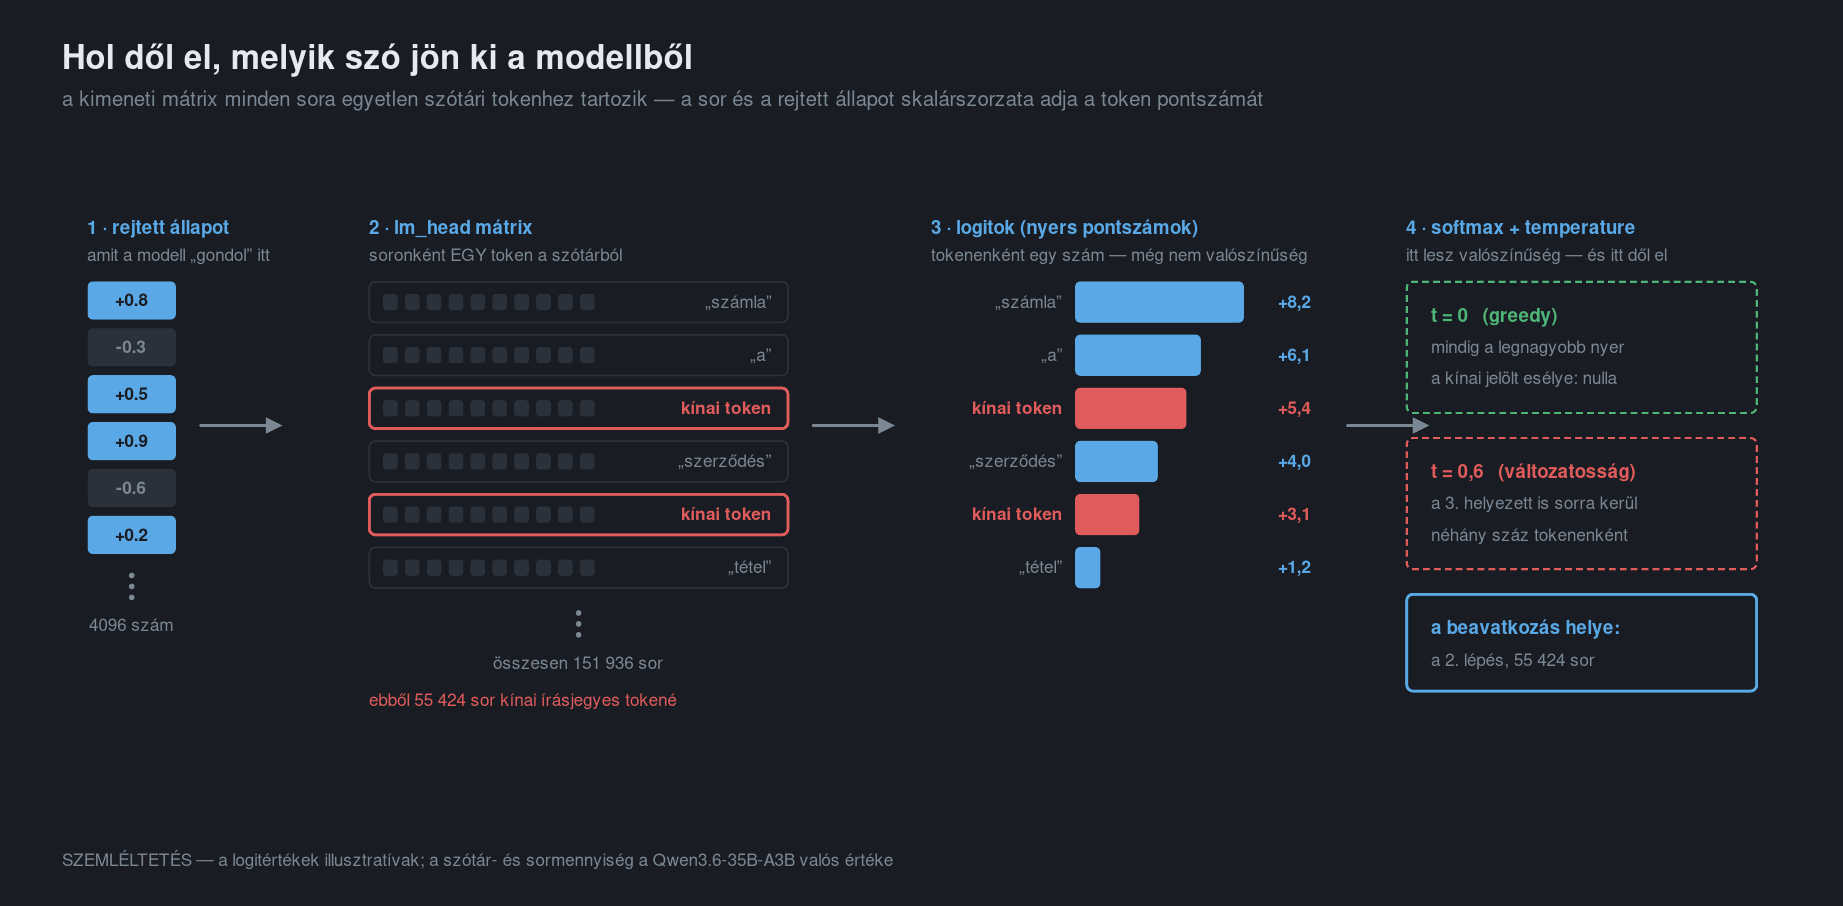
Egy nyelvi modell utolsó rétege, az lm_head, meglepően egyszerű: egy szótár, soronként pontosan egy tokennel. A sor és a modell belső állapotának szorzata adja a token logitját, vagyis a nyers pontszámát; ebből lesz valószínűség. A Qwen3.6 szótára 248 ezer elemű, és ebből 55 424 sor tartalmaz Han-írásjegyet. Ha ezeket a sorokat egy 1-nél kisebb számmal szorozzuk, a kínai tokenek logitja összemegy, a modell belső működéséhez pedig hozzá sem nyúlunk. Nem prompt, amit a modell elfelejthet. Nem tanítás, ami mindenhez hozzányúl. Nem dekódolási tiltólista, aminek minden hívásnál ott kell lennie. A tulajdonság magában a modellfájlban van: a checkpoint 55 fájljából egyetlen egy változik.
Két forma versenyzett. Az egyik a szorzás, a smoothie-qwen receptje. A másik egy koreai munkából ismert sorcsere, amely a célsorokat a magyar szöveg átlagos belső állapotának ellenirányába állítja. És két maszk: a nyers, amelyben minden Han-tartalmú token benne van, és a koreai mintájú finomított, amely meghagyja a gyakori egykarakteres írásjegyeket.
A kérdés, amit senki nem mért meg: mennyit?
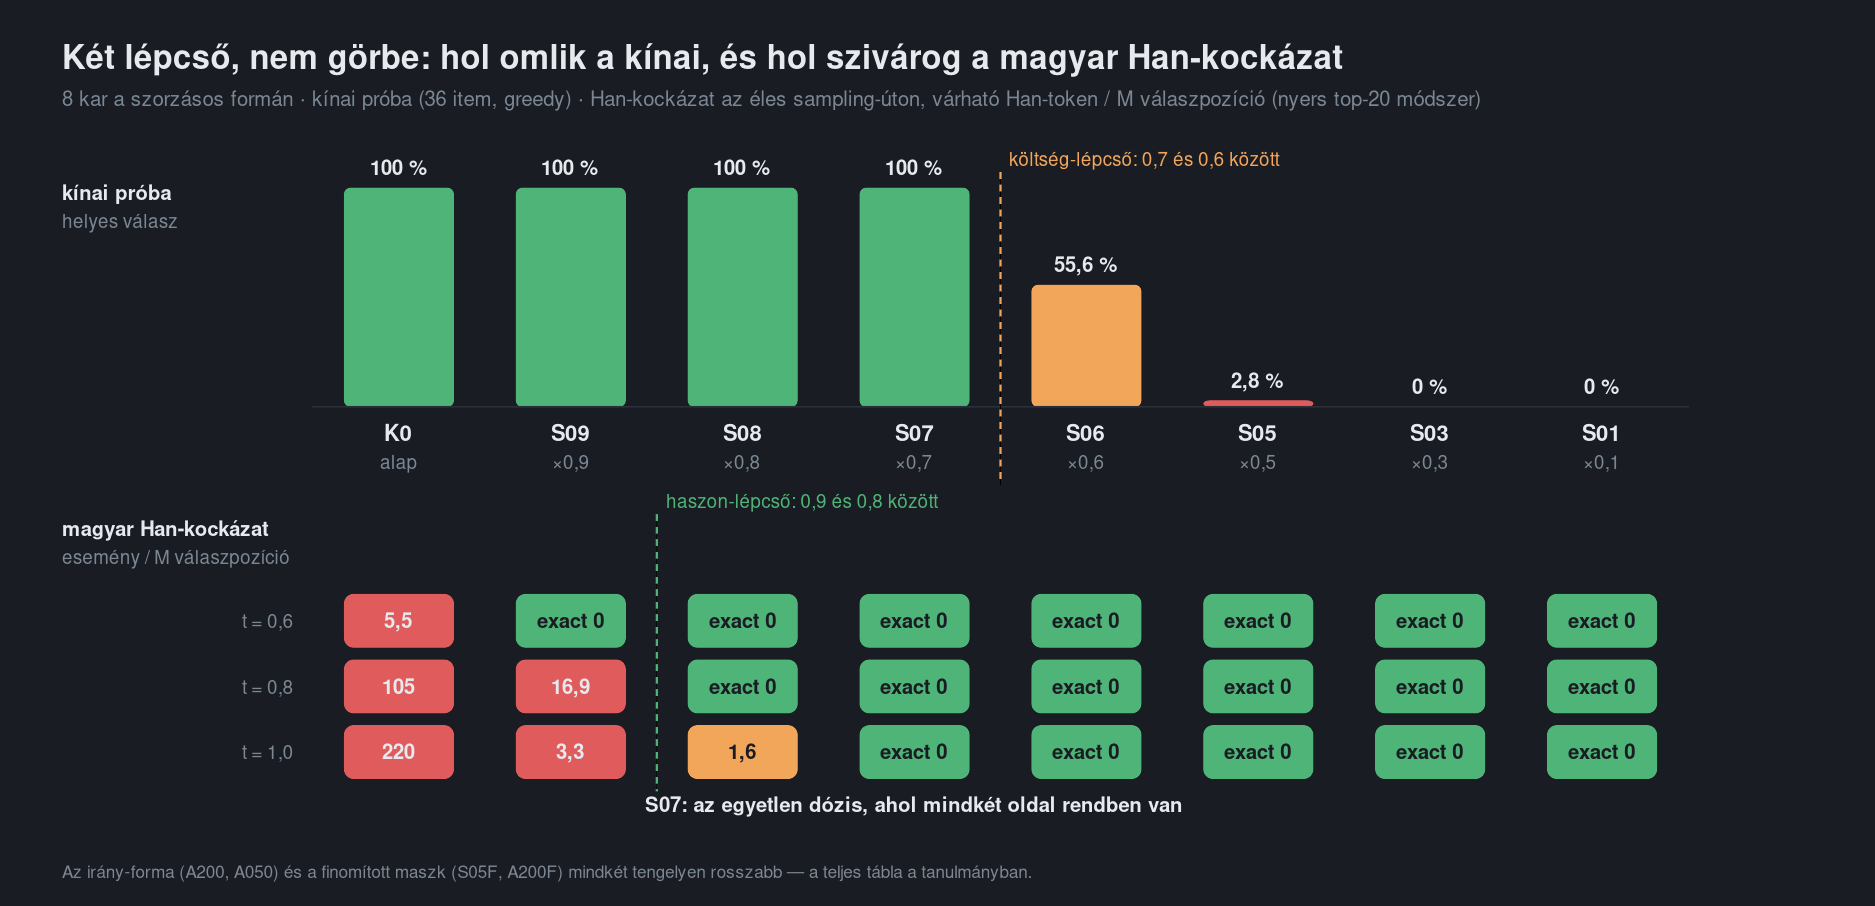
Ez a kép a kör lényege. Fent a költség: egy 36 rövid feladatból álló kínai próba, amelyen az eredeti modell hibátlan. Lent a haszon: a Han-kockázat három temperature-értéken, magyar ügynöki futásokon.
A két tengely két különböző helyen lépcsőzik. A kínai 0,7 és 0,6 között omlik, és ez nem lejtő, hanem szakadék: 0,5-nél a válaszok 97%-ában egyetlen kínai írásjegy sincs, a modell nem tud megszólalni. A Han-kockázat 0,9 és 0,8 között tűnik el. Az ablak létezik, és egyetlen mért dózis van benne: a 0,7. Közvetlenül a költség-lépcső szélén ül, lefelé tartalék nélkül.
A koreai sorcsere nem bizonyult olcsóbbnak: már fél erősségnél leöli a kínait. A finomított maszk pedig mindkét irányban elbukik: a meghagyott gyakori írásjegyek a kínait nem tartják használható szinten, a Han-kockázatot viszont beengedik. Amit koreaiul meg kell tartani, azt magyarul el lehet dobni.
A magyar ár: nulla, és tudjuk, miért
A protokoll elsődleges költség-műszere egy 150 feladatos magyar csapdakorpusz volt. Az első három változat után kiderült, hogy ez a műszer erre a beavatkozásra konstrukcióból vak. A folt csak a kínai sorok logitját változtatja, és magyar szövegen ezek soha nem nyernek: a greedy kimenet bitre ugyanaz. Sampling alatt is csak ott térhet el, ahol egy Han-token bent van a top-k húsz jelöltje között, vagyis pontosan azokon a pozíciókon, amelyek maguk a kockázat.
A nem-célnyelvi költség felülről korlátos a nem-célnyelvi kockázattal. Ha a folt egy magyar pozíción változtatna, ott az eredeti modell kínait tudott volna írni.
Ezt nyolc változat bájtra igazolta, a legerősebb, 0,1-es szorzó is. Három változat olyan kiszolgáló-állapotba esett, amelyben az eredeti modellről nincs mérésünk; ott ez levezetés, nem mérés. A költség egésze tehát abban a nyelvben van, amit elnyomunk, a csapdakorpuszból pedig negatív kontroll lett: azt bizonyítja, hogy a mérés nem lát fantomhatást.
Újramérés azon az eloszláson, amiből a modell tényleg húz
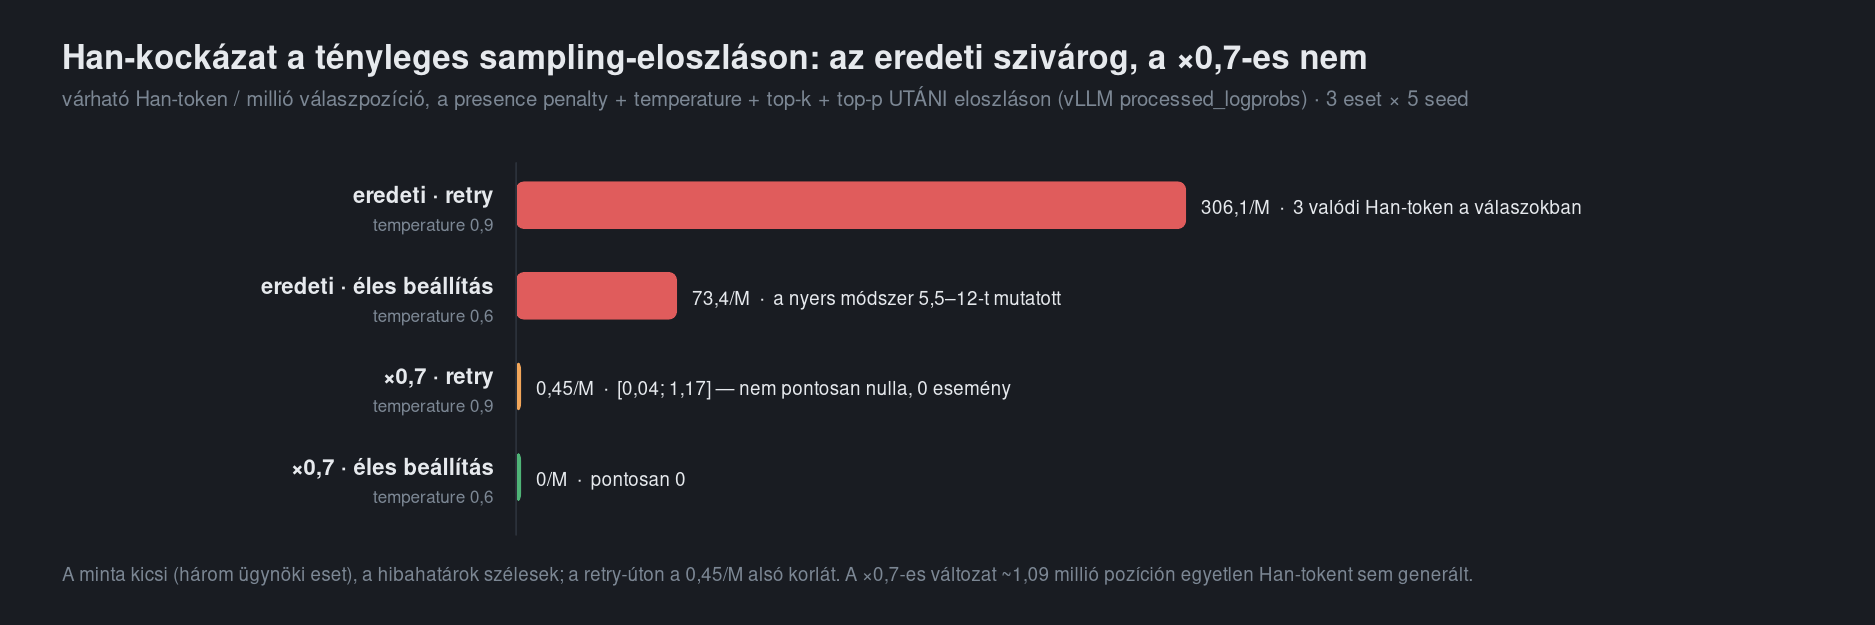
A fenti rács Han-kockázata a modell nyers jelöltlistájából készült. Egy olvasói észrevétel mutatott rá, hogy ez kevés: a vLLM a presence penalty-t a top-k levágás előtt alkalmazza, a már látott tokeneket lenyomja, és a hátrébb álló Han-jelöltek bejuthatnak a tényleges húszba. Újramértük úgy, hogy a kiszolgáló a teljes sampling-lánc utáni valószínűségeket adja vissza.
Az eredeti modell Han-kockázatát a nyers módszer nagyságrendileg alulbecsülte: 5,5–12/M helyett 73/M, három esetből, széles hibahatárral. A 0,7-es változat ugyanezen a tényleges eloszláson az éles beállításon pontosan nulla. A retry-úton, ahol a rendszer hurokgyanú esetén 0,9-es temperature-rel és erősebb presence penalty-vel próbálkozik újra, 0,45/M: nem nulla, esemény nélkül, és ez a szám alsó korlát.
A lezárás után minden futást újraszámoltunk, azokat is, amelyek nem jutottak el végső válaszig. A 0,7-es változat három friss kiszolgálón, 15 seeddel, párhuzamos terhelés alatt és 150 szintetikus iraton, összesen ~1,09 millió pozíción egyetlen Han-tokent sem generált. Az eredeti modell ugyanezeken a seedeken 65-öt, és a retry-úton egyetlen elszabadult generálásban további 6 593-at.
Amit ez a mérés nem bizonyít
A folt a kínai szót veszi el, a hurkot nem. Ugyanazon a seeden, ahol az eredeti modell elszabadult, a 0,7-es változat is elszabadult: kínai nélkül, de 65 ezer token szósalátával. A hurok-őr marad.
Egy modellt mértünk, egy kvantálással, egy motoron. A maszk a szótártól függ, más modellre semmi nem vihető át újramérés nélkül. A költségoldalon csak kínai próba volt; a japán kanji és a koreai hanja ugyanebbe a tartományba esik, tehát ugyanezt a veszteséget várjuk, de nem mértük, így nem is állítjuk. A Han-kockázat számai három ügynöki esetből jönnek. 0,6 és 0,7 között nem mértünk dózist.
És a folt csak csonkoló samplerrel működik. A célzott sorok 96%-ának a logitja magyar szövegen negatív, a szorzás ezeket a nulla felé húzza, tehát a nyers kínai valószínűségtömeg a folttól nő. A nullát a top-k levágás adja. Aki top-k és top-p nélkül samplingel, annak ez a modell nem segít.
A mérés közben a műszerről is tanultunk: a greedy kimenetet a batch size és a kiszolgáló friss indítása is átbillenti néhány feladaton, akkora mértékben, mint amit mérni akartunk. Ez külön történet, a tanulmány 7. fejezetében van.
Mit csinálunk most
A 0,7-es változat kis forgalmú, visszaállítható termelési próbára megy, a Han-előfordulás és a feladatminőség követésével. A döntési szabályt az adat előtt írtuk le, és mindhárom feltétele teljesült. A modell a Hugging Face-en Qwen3.6-35B-A3B-FP8-cjk-damped-S07 néven érhető el, Apache-2.0 alatt, a teljes dózis-hatás táblázattal és egy figyelmeztetéssel: ez nem jobb modell, hanem egy, amelyből tudatosan kivágtunk egy képességet. Akinek kínai, japán vagy koreai kimenet kell, annak kártétel.
Mi vihető el ebből, ha nem Qwent futtatsz
- Ha egy tokenosztállyal van bajod, az
lm_heada legolcsóbb hely. De a dózist mérd, ne találd el: nálunk az ablak egyetlen lépés széles volt. - A nem-célnyelvi ár felülről korlátos a nem-célnyelvi kockázattal. Ne a saját nyelveden keresd a költséget; ott van, amit elnyomsz.
- A nyers jelöltlista nem a tényleges eloszlás. Ha a kockázatot logprobból számolod, kérd a feldolgozott logprobot (
--logprobs-mode processed_logprobs). - Számold meg azt is, ami nem jutott el a válaszig. A legnagyobb kínai áradat nálunk egy olyan futásban volt, amelyet a számító kihagyott.
A mérések DGX Spark (GB10) gépen készültek, Qwen3.6-35B-A3B-FP8 modellel (Apache-2.0), vLLM alatt. A belső korpuszok és az ügynöki nyomvonalak ügyféladatot tartalmaznak, ezért nem publikusak; a cikkben szereplő minden szám aggregátum. A szintetikus csapdakorpusz, a kínai próba, a kód és minden változat kimenete a publikus műszereken a docai-evals repóban van. A beavatkozás alapja a dnotitia/smoothie-qwen recept; a legközelebbi előzmény a ThakiCloud/Qwen3.8-27B-ko-cjk-suppressed.