Kutatási jelentés
Mennyit szabad elvenni egy tokenosztálytól?
Egy magyar dokumentum-ügynök sampling mellett néha kínai kötőszavakra váltott. A javítás ismert: a kimeneti mátrix kínai sorait le kell skálázni. Ez a mérés azt kérdezi, amit előtte senki nem mért meg: mennyit szabad elvenni, és mi az ára — magyarul és kínaiul. Tizenkét kar, hat műszer, előregisztrált protokoll, és három lelet, ami menet közben magát a protokollt írta át.
A Qwen3.6-35B-A3B-FP8 kimeneti mátrixának (lm_head) 55 424 kínai
írásjegyes sorát skáláztuk le 0,9-től 0,1-ig, két beavatkozási formában és két
maszkkal, és minden kart hat műszeren mértünk. A dózis-hatás nem görbe, hanem
két lépcső: a kínai képesség 0,7-ig érintetlen (36/36), 0,6-nál már 55,6 %,
0,5-nél 2,8 %; a magyar szövegbe csúszó kínai kockázata a termelési
sampling-úton 0,8-tól lefelé exact nulla, 0,9-nél még szivárog. Az S = 0,7 az
egyetlen dózis, ahol mindkét oldal rendben van — a költség-lépcső szélén,
a haszon-lépcsőtől egy lépéssel beljebb.
A magyar költség konstrukcióból nulla: a folt csak kínai sorok
logitját változtatja, azok magyar szövegen soha nem argmaxok, ezért a folt
greedy magyar kimenete bájtra azonos az azonos példány-módú kontrolléval a
150 itemes csapdakorpuszon (nyolc folton mérve, háromnál levezetve). A költség egésze a kínain van. Az irány-alapú sorcsere nem olcsóbb,
a koreai mintájú finomított maszk mindkét tengelyen rosszabb.
És a legkellemetlenebb lelet: a temperature 0,3-ra csökkentése — az
addigi tűzoltás — nem véd: a tényleges sampling-tartón a kontroll
0,3-on 392/M kockázatot és valódi kínai tokeneket ad, mert a presence penalty a temperature-osztás
előtt hat, és alacsony temperature mellett erősebb. A mérőműszer háromszor bizonyult
hibásnak (batch size, kiszolgáló-példány, nyers top-20), mielőtt a modell egyszer is.
| kérdés | ítélet | mire épül |
|---|---|---|
| Dózis · van-e erősség, ahol a kockázat nulla, de a képesség ép? | Van: S = 0,7. | kínai 36/36 S ≥ 0,7-ig, 20/36 0,6-nál; Han-kockázat exact 0 S ≤ 0,8-nál, 16,9/M S = 0,9-nél t=0,8-on |
| Forma · olcsóbb-e az irány-alapú csere? | Nem. | α = 0,5 már 0/36 kínai; a mechanizmusa igaz (nyers tömeg exact 0), az ára nem kisebb |
| Maszk · megtartja-e a kínait a koreai mintájú finomítás? | Nem, és a kockázatot sem nullázza. | S05F: 19,4 % kínai, 11,3/M t=1,0-n; A200F: 2,8 %, valódi Han a válaszban |
| Magyar ár · fizetünk-e erős dózisnál? | Nem — konstrukcióból. | 150/150 item bájtra azonos az azonos módú kontrollal nyolc folton, S = 0,1-nél is (S08, S06, A050 módjában nincs kontrollmérés); a nem-célnyelvi költség felülről korlátos a nem-célnyelvi kockázattal |
Minden állítás egy modellen, egy kvantáláson, egy motoron mért. A korlátok a 9. fejezetben; a teljes eredménylap és minden kimenet a mellékletben.
A DocAI éjszakai ügynöki futásai magyar számlákon és szerződéseken dolgoznak,
samplinggel (temperature 0,6, presence_penalty 1,5),
mert a beragadt gondolatmenetekből változatosság nélkül nem lehet kijönni. Ebben az
üzemmódban a modell néha — egy-két token erejéig — kínaira váltott. Két
reflex volt: leszállítani a temperature-t 0,3-ra (ezt megtettük), és átírni a
kimeneti mátrixot egy ismert recept szerint (ezt egyszer, egyetlen erősséggel
kipróbáltuk, és működött). Ami hiányzott: a szám. Hol az optimum, mibe kerül, és
jó formájú-e a beavatkozás. Erre készült ez a kör — és közben kiderült, hogy a
tűzoltás sem az volt, aminek hittük.
1. fejezetA kérdés: dózis és forma
A kutatási kérdés a protokollban így áll: egy nyelvi modell kimeneti mátrixában egy tokenosztály elnyomása megszünteti a nem kívánt nyelvváltást — mennyit szabad elvenni, mielőtt fizetünk érte, és melyik beavatkozási forma fizet kevesebbet ugyanazért a haszonért? Két alkérdés, külön mérve:
- (A) Dózis. Van-e olyan erősség, ahol a kockázat már nulla, de a képesség még sértetlen — és hol?
- (B) Forma. Ugyanazért a kockázat-nulláért a szorzás vagy az irány-alapú csere fizet kevesebbet, magyarul és kínaiul?
A hipotéziseket (H1–H6), a cáfolati kritériumokat, az elsődleges végpontokat, a statisztikai eljárást és a publikálási döntési szabályt 2026. szeptember 15-én rögzítettük, mielőtt egyetlen kar lefutott volna. Ami menet közben változott, az dátummal és okkal a protokoll naplójába került — ebből a naplóból lett a 7. fejezet.
2. fejezetA beavatkozás és a tizenkét kar
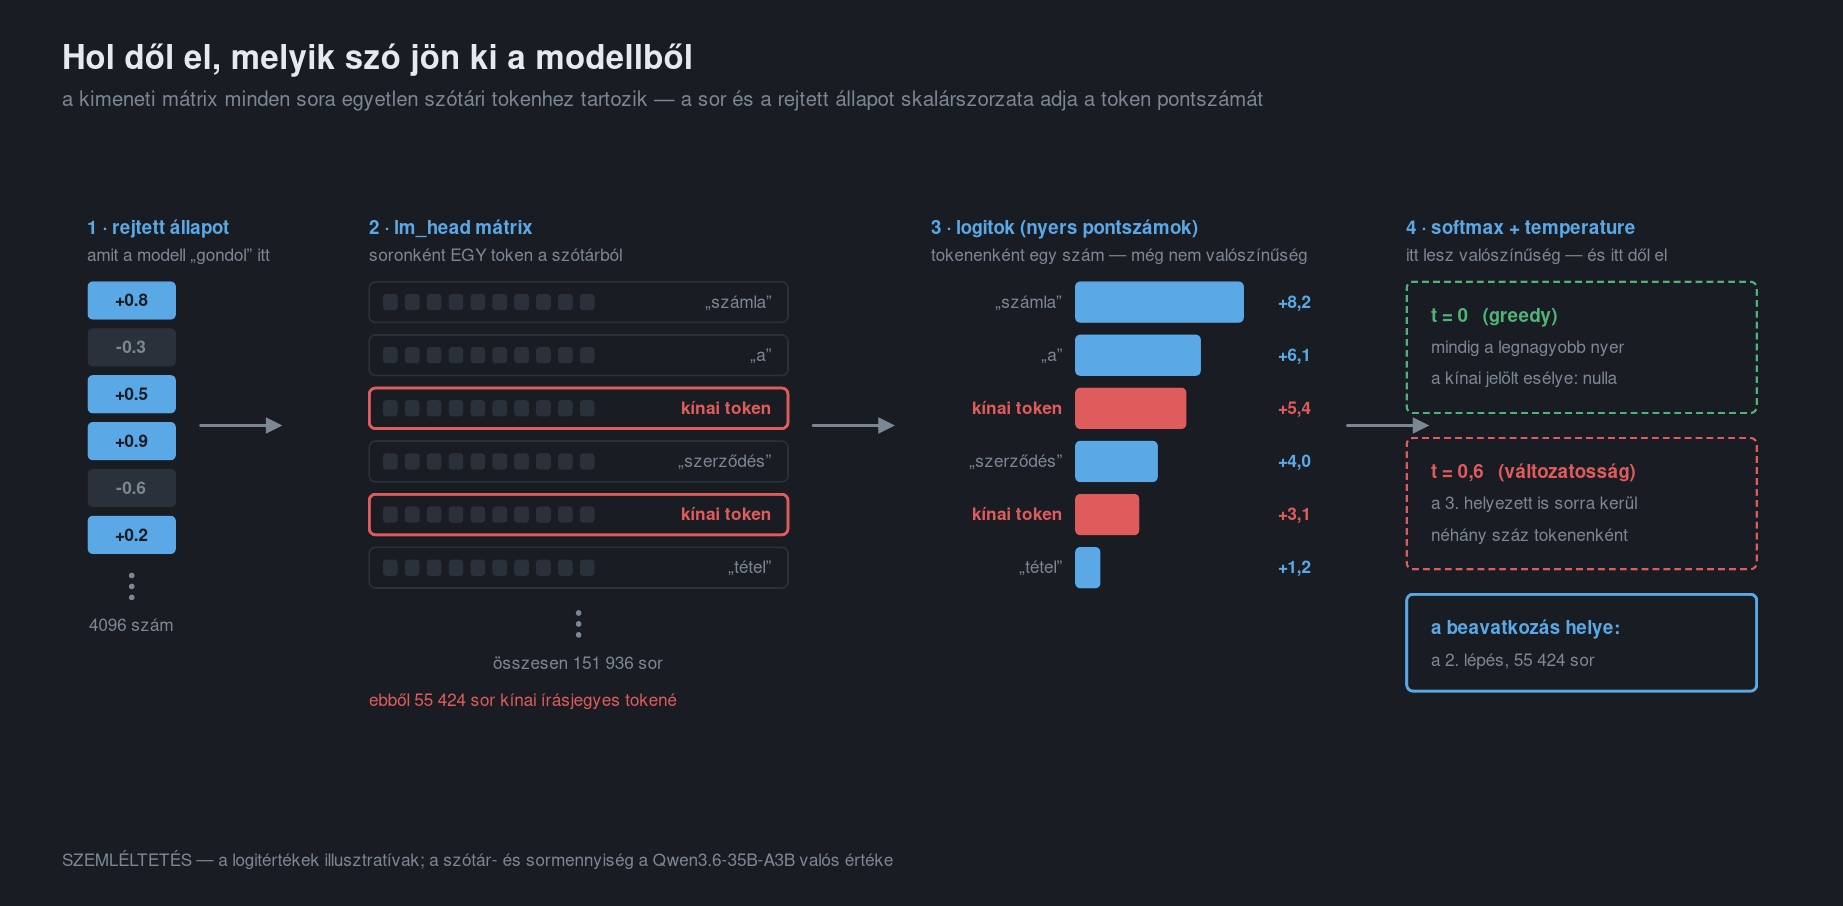
lm_head egy szótár, soronként egy tokennel: egy sor és a rejtett
állapot skalárszorzata a token pontszáma. A beavatkozás ezekből a sorokból 55 424-et
érint — azokat, amelyek dekódolt szövege kínai írásjegyet vagy CJK írásjelet
tartalmaz. A modell belső működéséhez nem nyúl.
Két forma versenyzett. A szorzás (Wi := S·Wi,
a smoothie-qwen
receptje) a célsorokat egy 1-nél kisebb számmal szorozza. Az irány-alapú
csere (Wi := −α·μh/‖μh‖²,
a ThakiCloud
koreai munkájából) a célsorokat a célnyelven mért átlagos rejtett állapot ellenirányába
állítja: a token pontszáma nem arányosan csökken, hanem egy negatív szintre kerül, a
korábbi előjeltől függetlenül. A μh-t 30 szintetikus magyar
promptválasz-páron mértük; egy független 30-as halmazon az irány koszinusza 0,889, tehát
nem a próbahalmaz műterméke.
Két maszk. A nyers maszk a smoothie-qwen Unicode-tartományai szerint minden CJK-tartalmú token (55 424). A finomított maszk a koreai munka mintájára készült: kana, csak-egyszerűsített karakterek és legalább kétkarakteres tisztán írásjegyes tokenek (54 939), és meghagy 3 964 gyakori egykarakteres írásjegyet — koreaiul ez a zárójeles hanja-használat miatt kell.
| kar | forma | maszk | paraméter | szerep |
|---|---|---|---|---|
K0 | — | — | — | a változatlan alapmodell |
S09 S08 S07 S06 S05 S03 S01 | szorzás | nyers | S = 0,9…0,1 | a dózis-sor (S05 a korábbi kör foltja) |
A200 A050 | irány | nyers | α = 2,0 / 0,5 | a forma-kérdés (H2) |
S05F A200F | szorzás / irány | finomított | 0,5 / 2,0 | a maszk-kérdés (H3, H4) |
Minden kar egyetlen tenzor átírása: az FP8-ra kvantált súlyokhoz hozzá
sem nyúltunk, a checkpoint 55 fájljából 54 bájtra azonos az alappal, és minden kart egy
507 ellenőrzéses igazoló nézett át fájl-, tenzor- és sorszinten a mérés előtt. A
S07 publikált változata a Hugging Face-en a
Qwen3.6-35B-A3B-FP8-cjk-damped-S07.
3. fejezetA műszerek és a protokoll
| műszer | mit mér | n | publikus |
|---|---|---|---|
| Han-szonda (haszon) | a várható kínai tokenszám millió generált pozícióra: minden pozíción a top-20 logprobból a kínai jelöltek össztömege a termelési sampling-lánc után (t 0,6/0,8/1,0, top_p 0,95, top_k 20, presence 1,5, repetition 1,05), válaszonkénti bootstrap CI |
3 magyar ügynöki nyomvonal (13–19 ezer token), 3–5 ismétlés × 3 temperature-érték | nem (ügyféladat); az aggregátumok igen |
| Csapdakorpusz (költség → negatív kontroll) | item-szintű átmenési arány 150 kinyerési és ítéleti feladaton, 16 szintetikus magyar iraton (50 régi + 100 valódi hibaosztályokból írt), greedy | 150 item, sorosan | igen |
| Kínai próba (költség) | 36 rövid kínai feladat 7 kategóriában (chengyu, mértékszó, ellentét, egyszerűsített–hagyományos, osztályozás…), pontos egyezés; plusz: a válaszok hány százalékában nincs egyetlen kínai írásjegy sem | 36 item, greedy | igen |
| Előjel-csapda | a célsorok nyers és csonkolt softmax-tömege a magyar átlagállapoton, karonként | offline | igen |
| belső KIE és szerződéskinyerés | megerősítő műszerek; a publikálási szabály 3. feltétele | 34 + 30 irat | nem |
A statisztika előre rögzítve: arányokra Wilson-intervallum, karok párosított
összevetésére McNemar (kis n-nél exact), a nyolc (később tizenegy) kontroll-ellenes
összevetésre Holm-korrekció, a nem-inferioritási margó −2 item a 150-es skálán. A
nulla esemény önmagában nem eredmény: minden „exact nulla” mellett ott a
megfigyelt eseményszámra épített Poisson felső korlát is. Négy kapu volt: az F0 (a
kontroll hozza-e a korábbi kört), az F1 (a pilot validálja-e a protokollt), az F2
(azonosítható-e S*) és az F3 (a győztes megerősítése) — és mindegyiknél
el lehetett volna állni.
4. fejezetEredmény: két lépcső, nem görbe
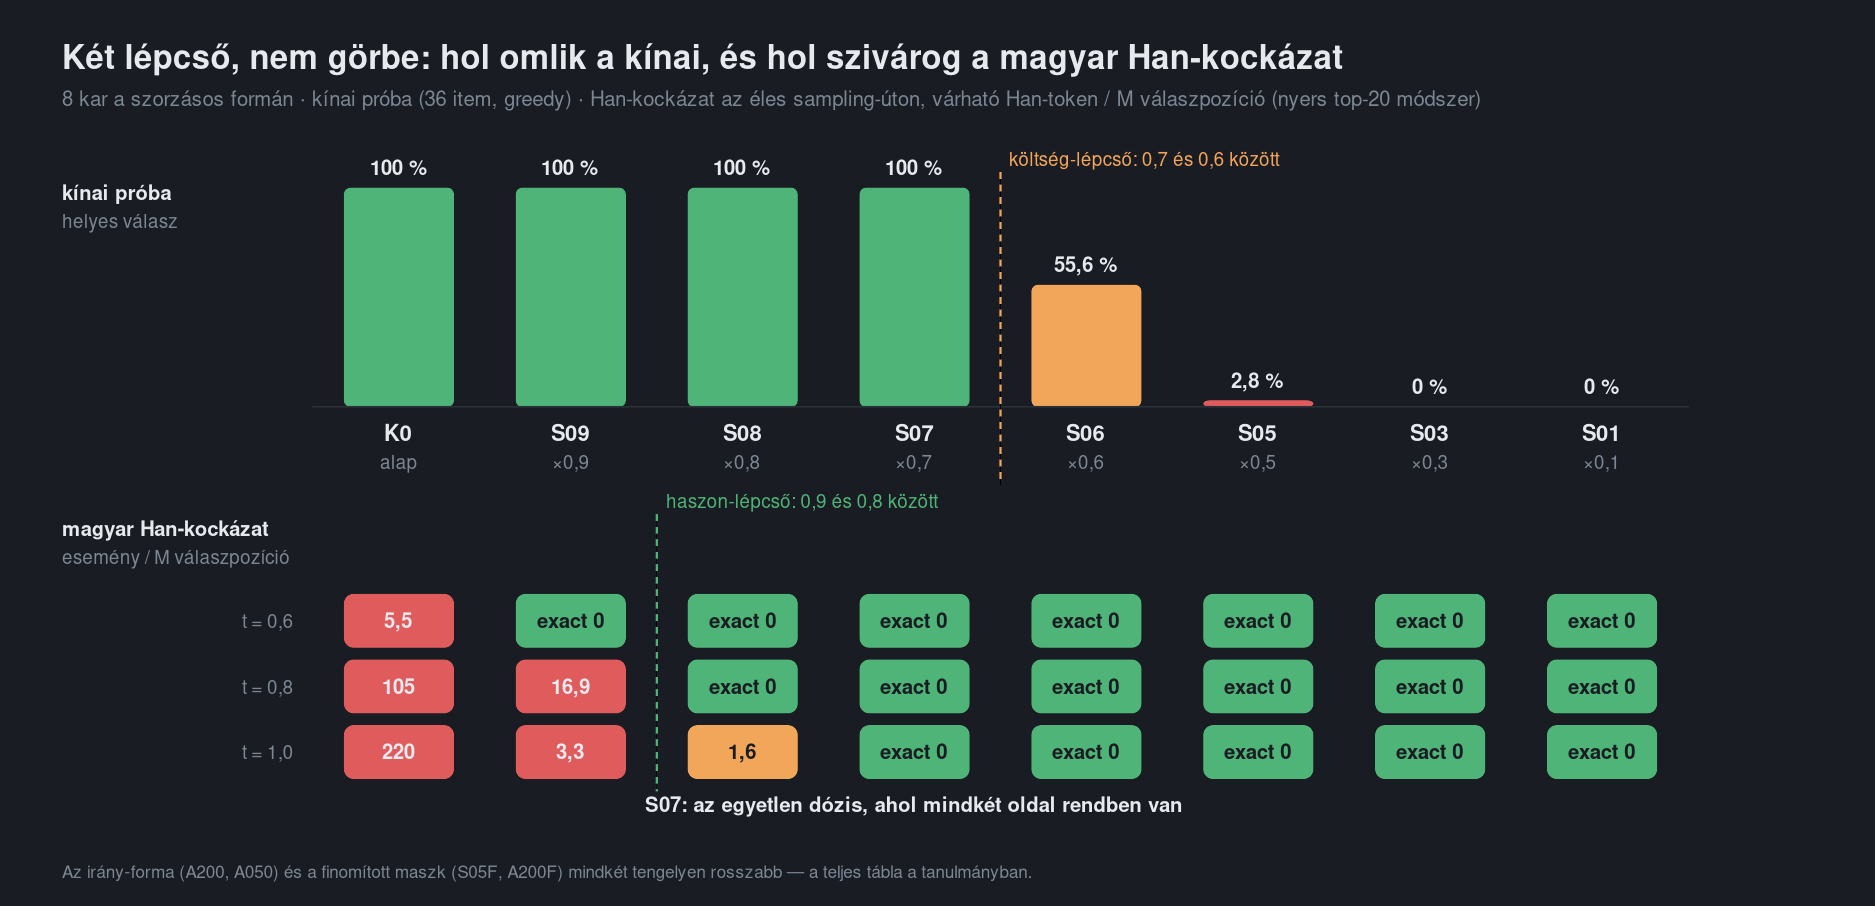
| kar | kínai próba | Han nélküli válasz | Han t=0,6 | t=0,8 | t=1,0 | csapda 150 |
|---|---|---|---|---|---|---|
K0 | 36/36 | 0 % | 5,5/M [0; 10,8] | 105/M [21; 248] | 220/M [70; 444] | 145/150 |
S09 | 36/36 | 0 % | exact 0 | 16,9/M [2,1; 37,9] | 3,3/M [0; 8,7] | 145/150 |
S08 | 36/36 | 0 % | exact 0 | exact 0 | 1,6/M [0; 4,8] | 143/150 |
S07 | 36/36 | 0 % | exact 0 | exact 0 | exact 0 | 145/150 |
S06 | 20/36 = 55,6 % | 44 % | exact 0 | exact 0 | exact 0 | 143/150 |
S05 | 1/36 = 2,8 % | 97 % | exact 0 | exact 0 | exact 0 | 145/150 |
S03 | 0/36 | 100 % | exact 0 | exact 0 | exact 0 | 145/150 |
S01 | 0/36 | 100 % | exact 0 | exact 0 | exact 0 | 144/150 |
A200 | 0/36 | 100 % | exact 0 | exact 0 | exact 0 | 145/150 |
A050 | 0/36 | 97 % | exact 0 | exact 0 | exact 0 | 143/150 |
S05F | 7/36 = 19,4 % | 44 % | exact 0 | 10,8/M [0; 23,2] | 11,3/M [0; 22,0] | 144/150 |
A200F | 1/36 = 2,8 % | 86 % | 4,3/M [0; 10,2] | 39,3/M [0; 104,8] | 2,6/M [0; 7,3] | 145/150 |
Mind a tizenkét lefuttatott kar; egyet sem hagytunk el. A kínai próba kontroll-ellenes McNemar p < 10−4 minden folton Holm után is, kivéve S07, S08, S09, ahol nincs diszkordáns pár. A csapda-oszlop a kiszolgáló-példányt méri, nem a kart (5. és 7. fejezet).
A költség egésze a kínain van, és szakadék, nem lejtő. Az S05-nél a
modell nem „rosszabbul tud kínaiul”: a válaszok 97 %-ában egyetlen
kínai írásjegy sincs — nem tud megszólalni. S07-nél a próba érintetlen. A lépcső
tehát 0,7 és 0,6 között van, és S07 közvetlenül a szélén ül, lefelé tartalék nélkül.
A haszon-lépcső a másik oldalon: S09 t=0,8-on már a
termelési úton szivárog, S08 csak t=1,0-n mutat 1,6/M-et. Az ablak létezik,
és egy dózis van benne.
Az irány-forma nem olcsóbb. A mechanizmusa igazolódott: az
előjel-csapda mérés szerint a nyers kínai tömeget pontosan nullára viszi, míg a
szorzás a nyers tömeget növeli (10,5 % → 13,4 % S07-nél →
16,1 % S05-nél t=1,0-n), mert a célsorok 96,4 %-ának negatív a
logitja, és a 0-hoz közelítés felfelé visz. De az α = 0,5 is leöli a
kínait (0/36). A szorzás nullái a top_k=20 csonkolás termékei — a
folt csak csonkoló samplerrel hatásos, és ez a model card kötelező mondata.
A finomított maszk mindkét irányban elbukik. A meghagyott 3 964
gyakori írásjegy a kínait nem tartja használható szinten (19,4 %, a válaszok fele
Han-mentes), a kockázatot viszont nem nullázza (S05F t=1,0-n 11,3/M; A200F már
a termelési úton 4,3/M, és t=0,8-on egy valódi kínai token a válaszban). Amit
koreaiul meg kell tartani, azt magyarul el lehet dobni — és el is kell.
5. fejezetA magyar költség: egy nullműszer
A protokoll elsődleges költség-végpontja a 150 itemes magyar csapdakorpusz volt. Az első három kar után kiderült, hogy ez a műszer erre a beavatkozásra vak — konstrukcióból. A folt kizárólag a kínai sorok logitját változtatja. Magyar szövegen ezek soha nem argmaxok: a szorzás a negatív logitokat nulla felé tolja, az irány-csere −α körüli szintre állítja, mindkettő messze a tipikus +15…30-as csúcs alatt. A greedy kimenet tehát bitre ugyanaz. Sampling alatt is csak ott térhet el, ahol egy kínai token benne van a csonkolt tartóban — vagyis pontosan azokon a pozíciókon, amelyek maguk a kockázat.
A nem-célnyelvi költség felülről korlátos a nem-célnyelvi kockázattal. Ha a folt egy magyar pozíción változtatna a kimeneten, ott a kontroll kínait tudott volna írni.
Ezt nyolc folt bájtra igazolta: a 150 item greedy kimenete azonos a vele azonos kiszolgáló-példány-módban futó kontrolléval — S = 0,1-nél is. Három kar (S08, S06, A050) olyan módba esett, amelyben kontrollmérés nincs; ott a tulajdonság levezetett, nem mért (az S08 és az S06 egymással bájtra azonos). A H1 („erős dózisnál fizetünk magyarul”) tehát minden dózisra cáfolva, és a csapdakorpusz szerepe megváltozott: nem költségmérő, hanem negatív kontroll, amely azt bizonyítja, hogy a mérés nem lát fantomhatást. Ez a protokoll naplójában dátummal áll; a költség tengelye a kínai próba lett.
Ugyanez a tulajdonság a Han-szondán is megjelent, meglepő formában: a motor rögzített seeddel fut, és ha egyetlen pozíción sincs kínai a top-20-ban, a csonkolt-újranormált eloszlás minden S-karon ugyanaz — az S07 és az S03 mind a 27, sampling alatt bejárt trajektóriája karakterre azonos. A folt ott és csak ott hat, ahol a kínai a tartóban lenne; máshol a modell viselkedése a dózistól függetlenül ugyanaz.
6. fejezetA tényleges tartó és a tűzoltás
A 4. fejezet kockázatszámai a rögzített nyers top-20 logprobra alkalmazzák a
sampling-láncot. A vLLM viszont a penaltyket a top-k előtt alkalmazza: a
presence_penalty=1,5 a már látott tokeneket lenyomja, és a nyersen 21.
vagy hátrébb álló jelölt bejuthat a tényleges top-20-ba — a számítás ezt nem
látja. Az előjel-csapda miatt az S-karoknál épp a kínai tokenek másznak felfelé. Az
„exact nulla” tehát a nyers top-20-ra volt bizonyított, a tényleges tartóra
nem. Ezért az F3-ban a kiszolgálót processed_logprobs módban futtattuk: a
visszaadott top-20 a penaltyk + temperature + top_k + top_p
utáni eloszlás, és a kockázat lánc nélkül, közvetlenül összegezhető.
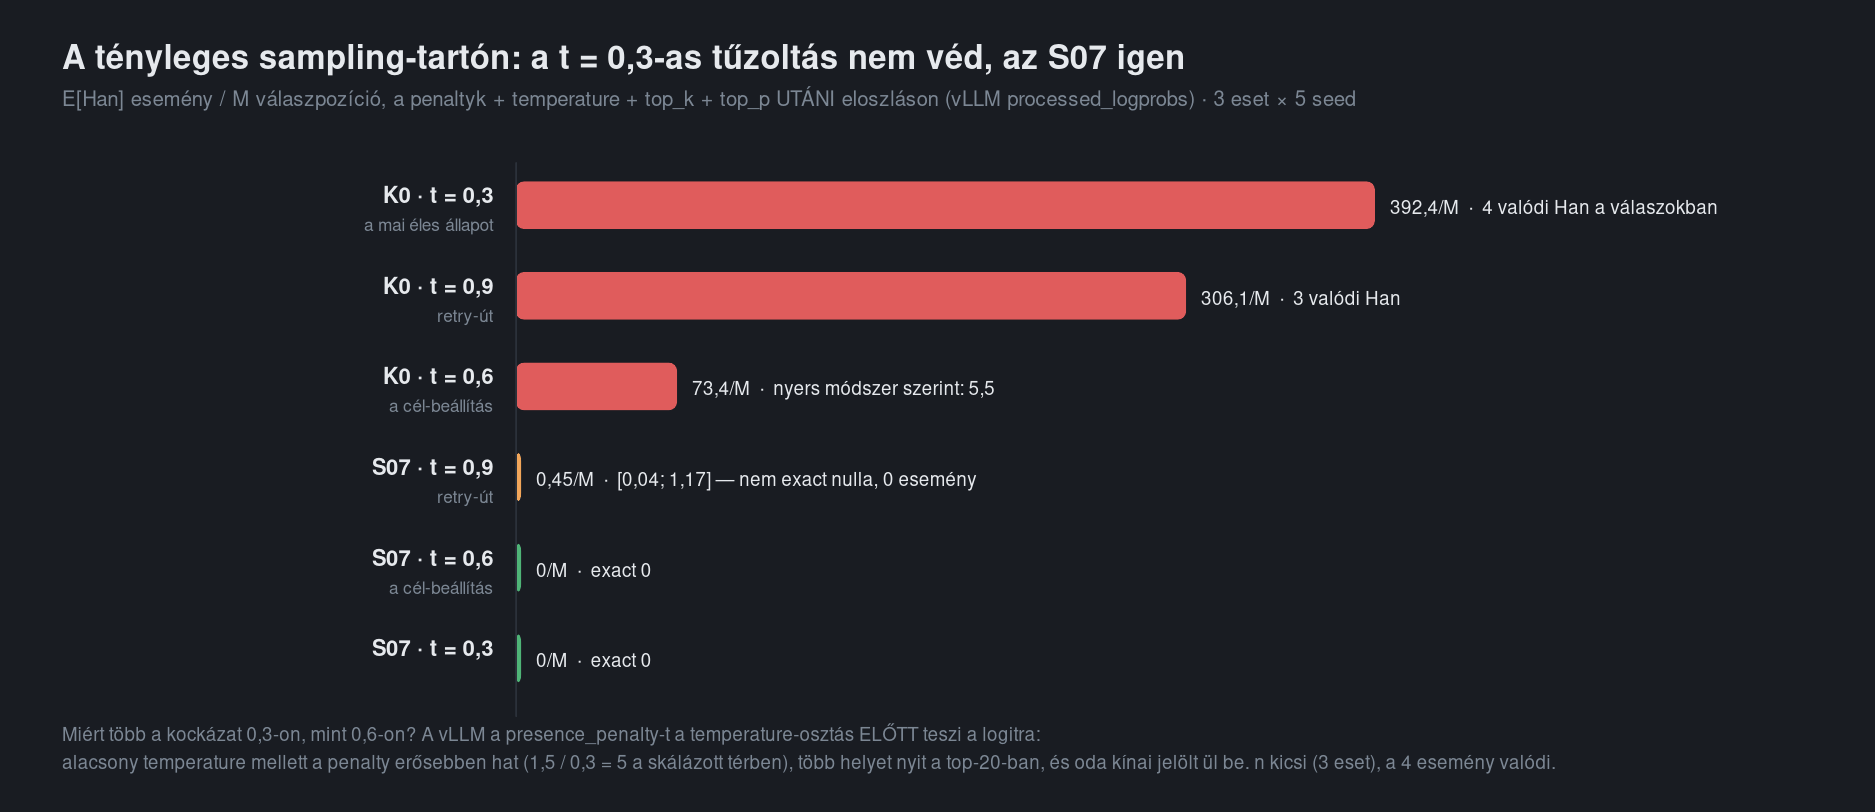
top_p 1,0, presence 1,8).
Két korrekció jött ki belőle. Az első: a nyers módszer a kontroll
kockázatát nagyságrendileg alulbecsülte (K0 @ 0,6: 5,5/M
és 12/M nyersen → 73,4/M [14,9; 148,1] a tényleges tartón; ez pontbecslések
hányadosa három esetből, nem mért szorzó). A 4. fejezet K0-számai alsó korlátok; a
foltok exact nullái viszont a tényleges tartón is állnak — egy kivétellel: az S07
a retry-úton 0,45/M [0,04; 1,17], megfigyelt esemény nélkül. Ez egy kínai
token 2,2 millió retry-pozíciónként, és a retry maga ritka;
de nem exact nulla, és így írjuk le. Ráadásul alsó korlát: top_p = 1,0
mellett a top-k határán álló holtversenyek bent maradnak, így a pozíciók ~4 %-án a
tényleges tartó 20-nál nagyobb, mint amit a rögzített top-20 lát.
A második a kellemetlen: a 0,3-as temperature nem véd. A tényleges tartón a kontroll 0,3-on 392/M, és 7 869 válaszpozíción 4 valódi kínai token — több, mint 0,6-on. A mechanizmus a sampler műveleti sorrendjében van: a presence penalty a logitra kerül, mielőtt a temperature-rel osztanánk, tehát alacsony temperatureen a presence penalty a skálázott térben erősebb (1,5/0,3 = 5), több helyet nyit a top-20-ban, és oda kínai jelölt ül be. Az n kicsi (három eset), a CI a nullát is tartalmazza — de a négy esemény valódi, és a „leszállítottuk a temperature-t, most jó” érzet ezzel megszűnt.
A megerősítés a sima, termelés-azonos motoron: három friss S07-példány, 15 seed, három
profil, egy háromszálas párhuzamos batch, és a 150 irat a termelési sampling-profilon
(~249 000 pozíció) — egyetlen kínai token sem, sehol, sem a
gondolkodásban, sem a válaszban. A kontroll ugyanezeken a seedeken 65-öt generált. És a
trajektóriák: K0 és S07 útja t=0,3-on 15/15 azonos,
0,6-on 13/15 — a két eltérő éppen az, ahol a kontroll kínait húzott.
Utólagos önellenőrzés (2026-09-20). A kockázatszámító csak a végső
válasszal záruló rekordokat nézi; az eszközhívással záruló köröket és az elszabadult
generálásokat gondolkodásostul kihagyja. Minden rekordot újraszámolva az S07 továbbra
is nulla generált kínai token ~1,09 millió különböző pozíción
(Poisson 95 % felső korlát: < 2,8/M) — a kontroll viszont az
retry-profilon egyetlen elszabadult generálásban 6 593 kínai
tokent írt, amit az eredeti tábla nem látott. És amit a folt nem old
meg: ugyanazon a seeden az S07 is elszabadult (a 65 536 tokenes plafonig, kínai
nélkül). A t=0,9 / top_p=1,0 profil 15 futásból 2-ben degenerál, folttal
vagy anélkül; a folt a kínai tokent veszi el, a szósalátát nem.
7. fejezetAmit a mérés közben elrontottunk
A korábbi kör legértékesebb része a törött mérőműszer és a visszavont javulás volt. Ez a kör négy ilyet hozott, és mindegyiket a kapuk fogták meg — egyet a felhasználó.
A csendben véletlenszerű szakértők. A μh
első becslése transformers-szel töltötte be az FP8-checkpointot; a MoE
szakértősúlyok elrendezése nem egyezett, és mind a 40 réteg összes szakértője
véletlenszerűen inicializálódott — a betöltés és az akkori önteszt hibátlannak
látszott. Átállás vLLM poolingra, és egy tanári kényszerítéses önteszt (top-1 66 %)
a kimenet előtt.
A batch size átbillenti a greedy kimenetet. A csapdát hat itemmel
párhuzamosítottuk, és a beépített kapu — 12 item sorosan, bájtra összevetve —
megbukott: a T7-08 párhuzamosan 3/3 átment, sorosan 3/3 elbukott. Nem zaj,
hanem feltételhatás, épp akkora, mint a mérni kívánt. Soros mérés lett belőle, ami nem
került többe, mert a soros dekódolás egy példányon belül bitre reprodukálható (150/150
item, 3 ismétlés), és az ismétlés elhagyható.
A kiszolgáló-példány is átbillenti. A friss példányon újramért kontroll
5/150 item PASS/FAIL-jében tért el az előzőtől; 16 indításból legalább öt
diszkrét numerika-mód jött ki, és az azonos módú példányok bájtra reprodukálják
egymást (két különböző kar csapdája és belső KIE-száma számjegyre azonos, ha egy módba
estek). A karok összevetése mindig két példány között történik, tehát ez a zaj minden
összevetésben benne van — a nullműszer-tulajdonság menti meg: a folt a magyar
greedy kimenetet nem érinti, ezért bármely eltérés a kontrolltól a példányt azonosítja,
nem a kart. A vLLM batch-invariáns módja (VLLM_BATCH_INVARIANT=1 +
TRITON_ATTN) két friss példányon 17/17 és a batch size-zal szemben is
bájtra azonosnak bizonyult, ~12 % lassulással; motorváltás lévén a kör a sima
motoron maradt, és ezt is naplóztuk.
A nyers top-20 nem a tényleges tartó. Ezt a 6. fejezet mondja el; a protokoll fejléce „alsó korlátnak” jelölte, de a prod-döntésre nézve alulértékeltük, amíg a kör vezetője rá nem mutatott, hogy a vLLM a presence penaltyt a top-k előtt alkalmazza. A javítás egy motorkapcsoló és tizenkét sor a kockázatszámítóban; az eredmény a kör legfontosabb üzleti lelete.
Három mérőműszer-hiba egy modellhiba előtt. A modellről szóló állítások mindegyike túlélte; a műszerekről szólók közül egy sem maradt úgy, ahogy a protokoll indult.
8. fejezetA hipotézisek verdiktje
| állítás (2026-09-15) | verdikt | alap | |
|---|---|---|---|
| H1 | erős dózisnál fizetünk magyarul | cáfolva, minden dózisra | 150/150 bájtra azonos S = 0,1-nél is; a költség egésze a kínain |
| H2 | az irány-csere mechanizmusa más, és olcsóbb | mechanizmus igazolt, „olcsóbb” cáfolva | nyers tömeg exact 0; A050 is 0/36 kínai |
| H3 | a finomított maszk megtartja a kínait | cáfolva | S05F 19,4 %, A200F 2,8 % |
| H4 | a finomított maszk is nullázza a kockázatot | cáfolva | S05F 11,3/M t=1,0; A200F 4,3/M a prod-úton, valódi Han a válaszban |
| H5 | a kockázat a temperature-rel nő | igazolt a kontrollon — de nem monoton, ld. 0,3 | 5,5 → 105 → 220/M (nyers); a tényleges tartón 0,3-on 392/M |
| H6 | a folt hatása a sampling-profiltól függ | igazolt | az S-karok nyers tömege nő; a nulla a top_k terméke; A200F t=0,8-on tényleges Han |
9. fejezetKorlátok
- Egy modell, egy kvantálás, egy motorbuild, egy hardver. A maszk a szótár függvénye; más modellre újra kell mérni, nem átvinni.
- Csak kínai a költségoldalon. A kandzsi és a hanja ugyanabba a tartományba esik, a veszteség ott várhatóan ugyanekkora — de nem mértük.
- Három ügyféladat-nyomvonal hordozza a magyar kockázatszámokat; a publikus ellenpár a 150 irat a termelési profilon, de ott a válasz rövid JSON, a pozíciók zöme a gondolkodásban van.
- Példány-zaj. A greedy számok példányról példányra 2–5 itemet mozdulnak; a publikált csapda-számok sorosak, és a példányt mérik.
- A nyers-módszeres kockázatszámok alsó korlátok; a kontroll a tényleges tartón ~10× rosszabb. Az S08-at nem mértük újra a tényleges tartón; 0,6 és 0,7 között nincs pont.
- A Poisson-korlátok 300–1 100/M karonként: az exact nulla a pozíciónkénti tömegre épül, nem az eseményszámra.
- Csonkoló sampler kell. Csonkolás nélkül az S-karok nyers kínai tömege nagyobb a kontrollénál.
10. fejezetDöntés és ami jön
A döntési szabályt az F3 adata előtt rögzítettük: a termelési próba akkor javasolható,
ha az S07 kockázata a tényleges tartón 0,6-on nem nagyobb a mai éles állapoténál
(K0 @ 0,3), a csapda a termelési profilon nem rosszabb, és három friss
példányon nincs megfigyelt kínai token. Mindhárom teljesül: exact 0 a 392/M ellen;
146/150 a 146/150 ellen (pontban jobb: 194,5 vs 191,0, formátumsértés 0 vs 2); nulla
esemény ~300 000 pozíción. Az S07 kis forgalmú, visszaállítható
termelési próbára javasolt, 0,6-on, a kínai előfordulás és a feladatminőség
követésével — és a mai 0,3-as állapot nem az a biztonságos hely, aminek látszott.
Ami nyitva maradt: az S08 a tényleges tartón (egy menet), a 0,6–0,7 közti pont a tanulmányhoz, a kandzsi/hanja mérése, és a batch-invariáns motor mint mérési út a következő körre.
A magyar dokumentumfeldolgozás samplinggel futó útjai a csillapított modellel visszatérhetnek a 0,6-os üzemre, kínai kockázat nélkül és magyar ár nélkül. A tanulság általánosabb, mint a kínai: ha egy tokenosztállyal van baj, a kimeneti mátrix a legolcsóbb hely, ahol hozzá lehet nyúlni — de a dózist mérni kell, nem eltalálni, és a mérőműszert előbb kell kétségbe vonni, mint a modellt.
MellékletApparátus
Modell:
Qwen3.6-35B-A3B-FP8-cjk-damped-S07 a Hugging Face-en, Apache-2.0, a teljes
dózis-hatás táblázattal és a sampler-kitétellel a model cardon.
Mérési csomag (kód, szintetikus korpusz, kínai próba, minden kar kimenete a
publikus műszereken, eredménylap, a példány-módok igazolásai):
docai-evals → 2026-09-18-cjk-damping-dose-response-gb10.
Protokoll: az előregisztrált runbook és az F0–F3 jegyzőkönyvek
(magyarul) ugyanott, a protocol/ alatt.
Előzmények: dnotitia/smoothie-qwen
(a célosztály definíciója) és
ThakiCloud/Qwen3.8-27B-ko-cjk-suppressed
(irány-alapú csere, nyelvspecifikus maszk). Ami ez a kör hozzátett: a dózis-sor, a két
forma és a két maszk egymás elleni mérése, a nullműszer-levezetés, és a tényleges
sampling-tartón mért kockázat.
Rövid változat: a blogon, Kínai szavak a magyar válaszban.