Az általános döntési adapter, amely nem lett általános
Egy több mint kétszáz feladatcsaládon tanított adapter több esetben dönt, de az ismeretlen feladatokon akkor is kiválaszt valamit, amikor az „egyik sem” lenne a jó válasz.
Október 9-én arról írtunk, hogy egy kis döntési adapter ugyanazzal a recepttel tanítva a számlasorok cikkhez rendelésében (a továbbiakban: termékpárosítás) 13,7 ponttal több sort automatizál, az eszközválasztásban viszont rosszabb, mint a tanítás nélküli modell. Kézenfekvő volt a következő kérdés: ha egyetlen adaptert sok különböző feladaton tanítunk, átviszi-e a nyereséget olyan feladatra is, amelyet sosem látott?
Lezártuk a kört, és a válasz: nem. Az adapter mindenhol többet dönt, de a tanításból kihagyott feladatokon nem éri el a kitűzött pontosságot. A termékpárosításban és az eszközválasztásban a hibák szinte mind ugyanonnan erednek: az adapter ott is kiválaszt valamelyik lehetőséget, ahol a helyes válasz az, hogy „egyik sem”. Ez negatív eredmény, és ahogy megígértük, ezt is közzétesszük, az adapterrel és a tanítóadattal együtt.
Mit próbáltunk ki
A modell ugyanaz, mint korábban: Qwen3.6-35B-A3B, vLLM alatt, a saját GB10-es gépünkön. Az adapter itt is egyetlen döntést ad: a felkínált 2–10 lehetőség betűjelét, vagy azt, hogy egyik sem illik. A válasz valószínűségére küszöböt teszünk: ha a modell nem elég biztos, a döntés emberhez kerül.
Ezúttal 17 500 tanítóelemet raktunk össze 207 feladatcsaládból. Az elemek háromnegyede 21 magyar családból származik: jogszabályok és közbeszerzési hirdetmények feldolgozása, szövegértés, következtetés, levelek osztályozása, entitások felismerése és egyeztetése, keresési találatok megítélése. A maradék negyed angol döntési feladat, 186 kisebb családból. Minden elemnél ott volt az „egyik sem” lehetőség, és az esetek közel egytizedében ez volt a jó válasz, négy típusban:
- a jó válasz lekerült a listáról, de egy hasonló maradt;
- a forrás maga jelöli megválaszolhatatlannak;
- a kérés egészen más feladathoz tartozik;
- a döntéshez hiányzik egy adat.
Tanármodellt nem használtunk, és zárt modell kimenete sem került a tanítóadatba: a címkék a forrásokból vagy a feladat szerkezetéből jöttek. Az elemek 16 %-a szintetikus (például levelek, entitások, ügytípusok): ezeket nyílt licencű modellek írták, és csak azok maradtak meg, amelyeknél egy másik modellcsalád független ellenőrzéskor ugyanarra a címkére jutott. Az „egyik sem” eseteknél a tanítási célfüggvény egy külön tagja a tanítás nélküli modell eloszlása felé húzta az adaptert. Ennek kellett volna biztosítania, hogy az „egyik sem” felismerése ne romoljon.
A mérés három feladatcsoporton futott, amelyekből semmi sem került a tanításba:
- termékpárosítás: számlasor → cikktörzs, az október 9-i cikk tesztje;
- eszközválasztás: melyik eszközt hívja az ügynök, vagy egyiket se (BFCL, When2Call, magyar kérések);
- számlaellenőrzés: kérdések szintetikus számlákról (dátum, mező, végösszeg).
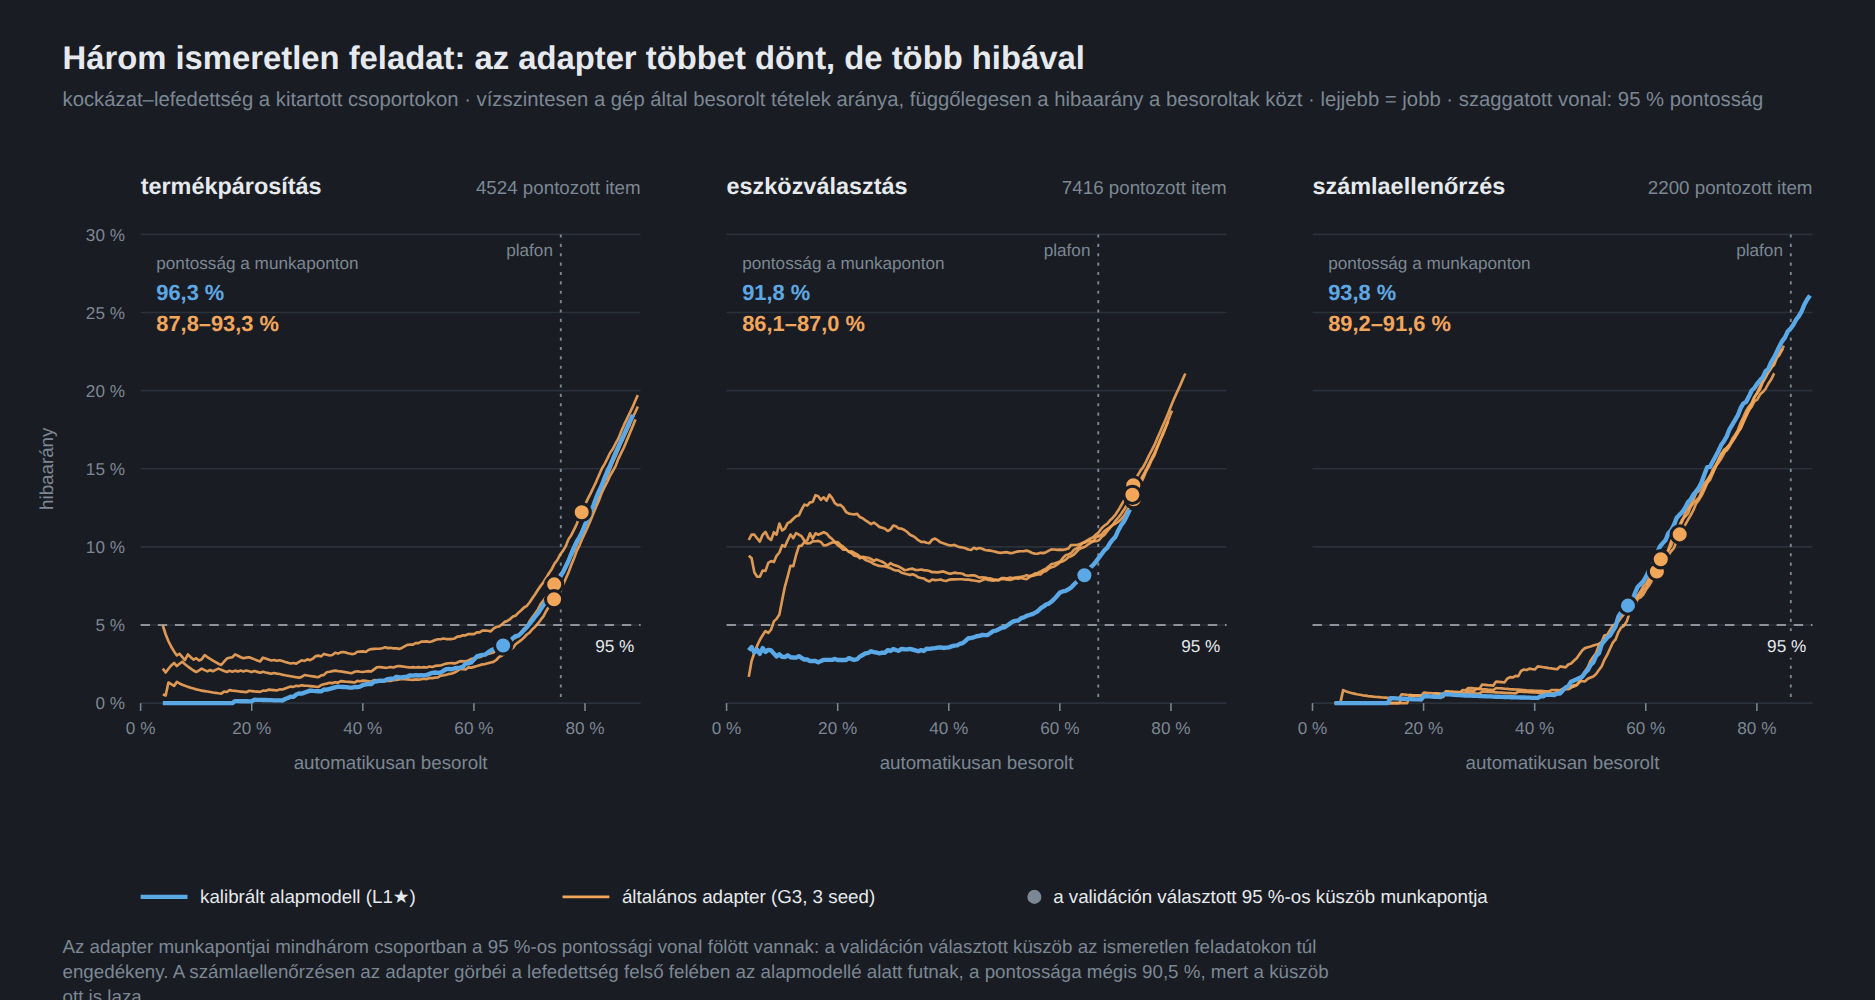
A mérce a korábbi: hány esetet visz automatikusan a rendszer, ha a besorolások 95 %-ának helyesnek kell lennie. A gép által eldöntött esetek közül a helyesek arányát a továbbiakban pontosságnak hívjuk. A küszöböt egy külön, a tanítóadattal azonos típusú validációs halmazon választottuk. Bukási határnak a 93 %-ot vettük: ha a teszten a besorolásoknak ennél kisebb része helyes, az adapter elbukott. Az összevetés alapja ugyanaz a modell tanítás nélkül, gondosan kalibrálva (hogy ez mit jelent, az előző cikkben leírtuk); a táblázatokban ez a kalibrált alapmodell. A hipotéziseket és a döntési szabályokat október 14-én rögzítettük, mielőtt az adapter teszteredményeit megnéztük volna.
Az eredmény
| kalibrált alapmodell | általános adapter | |||
|---|---|---|---|---|
| automatikus | ebből helyes | automatikus | ebből helyes | |
| termékpárosítás | 65,3 % | 96,3 % | 76,1 % | 91,2 % |
| eszközválasztás | 64,4 % | 91,8 % | 73,2 % | 86,6 % |
| számlaellenőrzés | 56,8 % | 93,8 % | 63,6 % | 90,5 % |
Az adapter mindhárom csoportban 7–11 ponttal több esetet visz automatikusan, de egyikben sem tartja a pontosságot: a besorolásainak 86,6–91,2 %-a helyes, a cél 95 % volt. Az adapter tehát mindhárom csoportban elbukott az előre rögzített feltételen. Az eredmény három tanítási ismétlés átlaga; a pontosság egyik ismétlésben sem érte el a 95 %-ot. Az eszközválasztásban a tanítás nélküli modell maga is a 93 %-os határ alatt van; a kérdés ott az volt, hogy az adapter javít-e rajta.
Egy előre rögzített mellékkérdés formálisan „átvitelt” mutatott: a termékpárosításban az általános adapter ugyanannyival növeli az automatikus döntések arányát, mint a korábbi, feladatspecifikus adapter. Ez a mérce azonban csak az automatikus arányt nézte, a pontosságot nem: a feladatspecifikus adapter 97 %-os, az általános 91 %-os pontossággal éri el ezt a növekedést. Erre ezért nem építünk.
Honnan jönnek a hibák
Ahol van jó válasz, ott az adapter pontos. A termékpárosításban és az eszközválasztásban az ilyen elemeken hozott döntései 99,1–99,3 %-ban helyesek, a tanítás nélküli modellé 99,5–99,7 %-ban. A választás tehát nem romlott el.
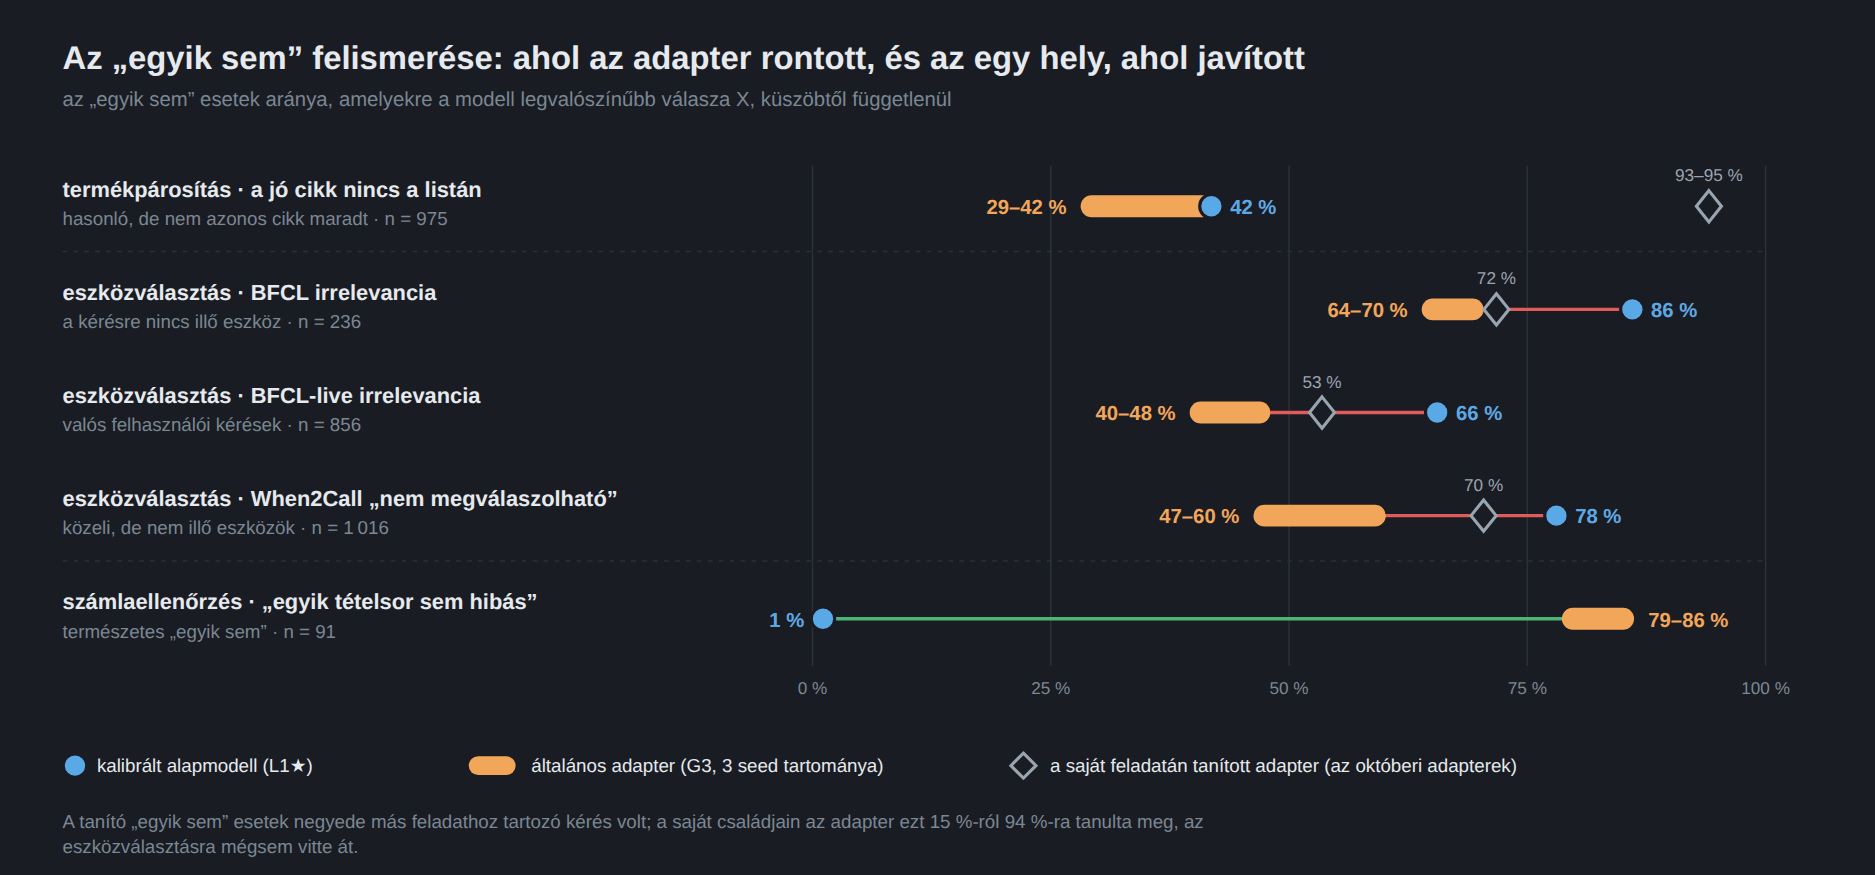
A gond az „egyik sem” esetekkel van. Ezek közül az adapter a termékpárosításban 25 %-ot, az eszközválasztásban 28 %-ot a küszöbnél nagyobb bizonyossággal valamelyik lehetőséghez rendel. A tanítás nélküli modell 9, illetve 15 %-ot. Ráadásul nem bizonytalanul: az eszközválasztásban az adapter hibáinak fele legalább 95 %-os bizonyossággal születik (a tanítás nélküli modellnél a hibák 39 %-a).
A számlaellenőrzésben más a kép: ott a hibák zöme rossz választás, főleg a végösszegre vonatkozó kérdéseknél. Ezekhez számolni kellene, és gondolkodási lépés nélkül minden változat gyengén teljesít rajtuk (59–63 %-os pontosság).
A legélesebb a különbség a valódi, irreleváns kéréseknél, ahol egyik eszközt sem kellene hívni:
| „nincs illő eszköz” felismerése | kalibrált alapmodell | általános adapter |
|---|---|---|
| When2Call | 78 % | 54 % |
| BFCL-live irrelevancia | 66 % | 45 % |
| BFCL irrelevancia | 86 % | 67 % |
Pedig a tanítás kifejezetten tartalmazott ilyen eseteket: a tanító „egyik sem” elemek negyedében a kérés egy másik feladathoz tartozott. A saját feladatcsaládjain az adapter ezt meg is tanulta: ott az ilyen esetek felismerése 15 %-ról 94 %-ra nőtt. Az ismeretlen feladatra mégsem vitte át, és a célfüggvénynek a tanítás nélküli modell felé húzó tagja sem akadályozta meg a romlást. A feladatspecifikus eszközválasztó adapter ugyanígy elbukott, holott ott a feladat szerepelt a tanításban. Ez arra utal, hogy a jelenség nemcsak a feladatspecifikus tanítóadat „egyik sem” eseteinek összetételéből ered, hanem magából a döntésre tanításból is.
Miért nem viszi át az adapter az „egyik sem” felismerését?
Szerintünk azért, mert az, hogy mikor nem illik egyik lehetőség sem, területenként más konvenció. A termékpárosítás „egyik sem” eseteit a saját területén tanított, feladatspecifikus adapter 94 %-ban ismeri fel, a tanítás nélküli modell 42 %-ban, az általános adapter 34 %-ban. Az általános tanításból a modell inkább azt tanulja meg, hogy ha van hasonló lehetőség, azt válassza. Ez az ismerős feladatokon jó stratégia, az ismeretleneken magabiztos hibákat ad.
Egy utólagos megfigyelés is ide tartozik. A tanítóanyag angol negyede nélkül tanított változat az angol eszközválasztás irreleváns kéréseinél sokkal kevésbé romlik: a When2Call-on 54 helyett 75 %-ot ismer fel. Ebből az látszik, hogy az angol döntési adat az angol eszközkéréseken a „hívd meg” felé tolja a modellt. Egyetlen tanítási ismétlésen láttuk, külön nem mértük, ezért csak irányt mutat; a magyar eszközkéréseken ugyanez az anyag segített (lásd lejjebb).
Azonos pontosság mellett nincs nyereség
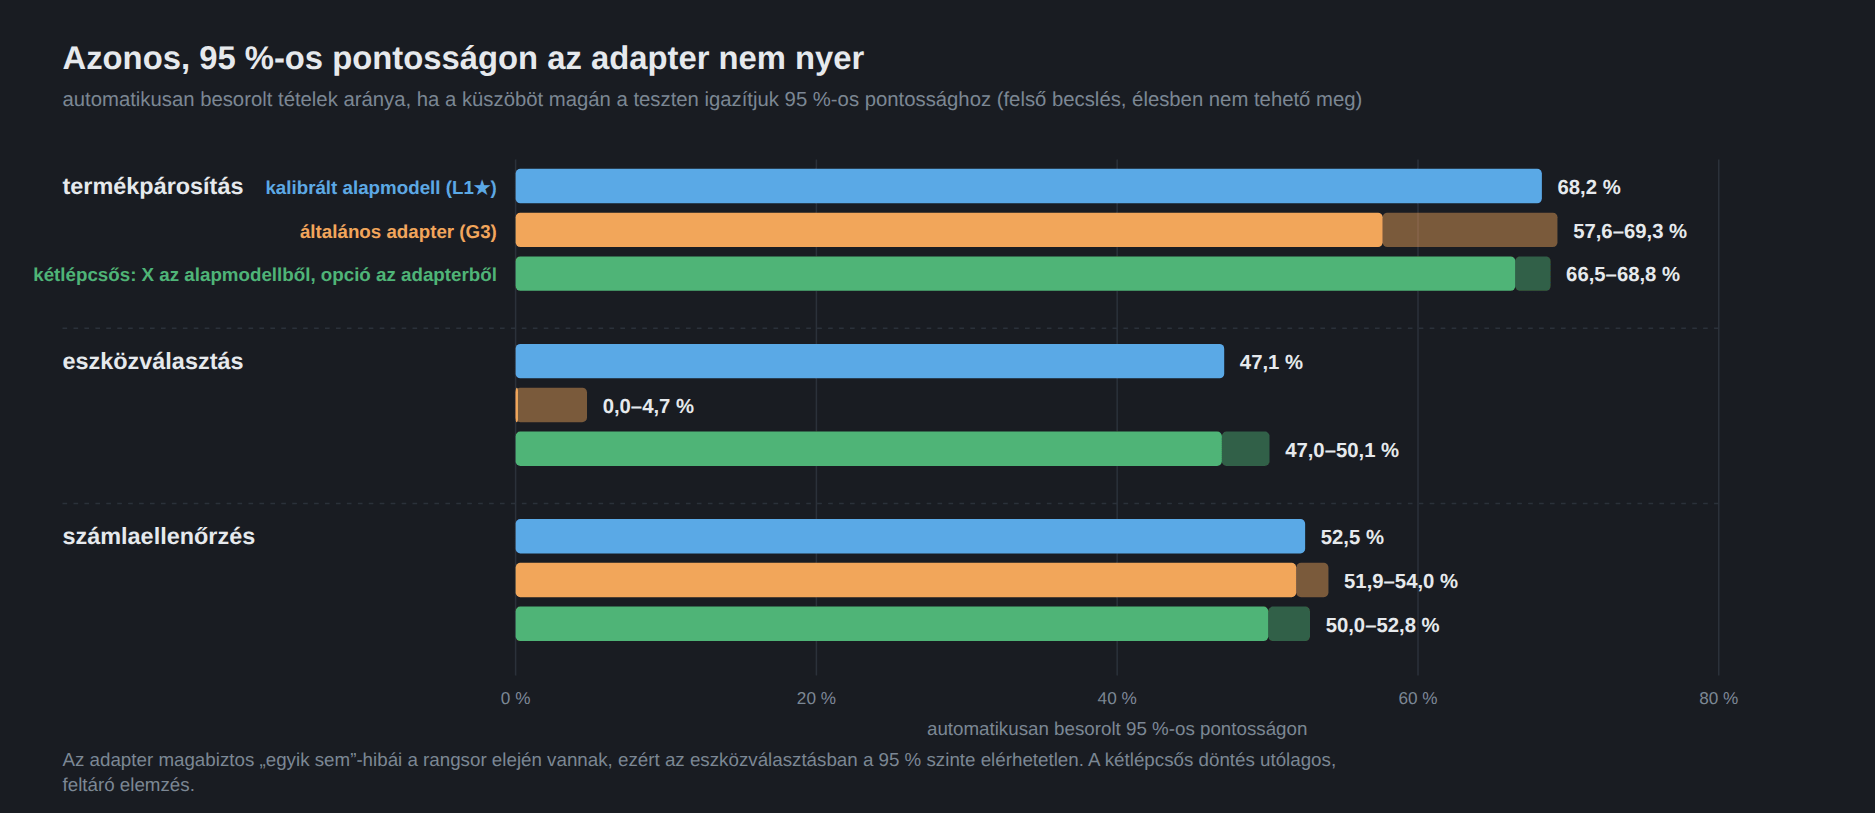
A „több automatikus döntés” első ránézésre jól hangzik, de érdemes megnézni, mi történik, ha mindkét modellt ugyanarra a pontosságra állítjuk. Ehhez a küszöböt magán a teszten igazítottuk 95 %-os pontossághoz. Élesben ez nem járható út, ezért az alábbi számok felső becslések:
| automatikus besorolás 95 %-os pontosság mellett | kalibrált alapmodell | általános adapter |
|---|---|---|
| termékpárosítás | 68,2 % | 65,0 % |
| eszközválasztás | 47,1 % | 1,6 % |
| számlaellenőrzés | 52,5 % | 52,8 % |
Azonos pontosság mellett az adapter sehol sem jobb érdemben, és az eszközválasztásban gyakorlatilag semmit nem tud automatizálni. A magabiztos hibák a rangsor (a döntések bizonyosság szerinti sorrendje) legelején vannak, ezért ott a 95 % elérhetetlen. A termékpárosításban és az eszközválasztásban az első táblázat magasabb automatikus aránya tehát nem jobb rangsorból ered, hanem abból, hogy a validáción választott küszöb az ismeretlen feladatokon túl engedékeny. A számlaellenőrzésben az adapter teljes rangsora valóban jobb, de a 95 %-os pontossági tartományban ez nem látszik.
Kipróbáltuk azt is, mi történik, ha a küszöböt a célfeladatból vett, legfeljebb 200 elemes mintán választjuk. A termékpárosításban és az eszközválasztásban így sem találtunk olyan küszöböt, amely teljesítette volna a küszöbválasztási szabályt – a tanítás nélküli modellnél sem: ha a rangsor elején magabiztos hibák vannak, ekkora mintához ez a szabály túl szigorú. A számlaellenőrzésben a módszer működött, de ott az adapter annyit tudott, mint a tanítás nélküli modell.
Megmentheti-e egy kétlépcsős döntés?
Utólag, a meglévő mérésekből kipróbáltunk egy kézenfekvő javítást. Azt, hogy az „egyik sem” a jó válasz-e, a tanítás nélküli modell dönti el; ha szerinte van jó válasz, az adapter választja ki. A romlás így eltűnik: az eszközválasztásban a pontosság 86,6 helyett 91,6 %, vagyis a tanítás nélküli modell szintje.
Nyereség viszont alig jut. Azonos pontosság mellett a kétlépcsős döntés nagyjából annyit automatizál, mint a tanítás nélküli modell: a termékpárosításban 67,5 %-ot a 68,2 %-kal, az eszközválasztásban 49,0 %-ot a 47,1 %-kal szemben. Ennek oka a fentebb látott plafon: ahol van jó válasz, ott a tanítás nélküli modell ebben a két csoportban már eleve szinte hibátlan, így az adapternek kevés hozzátennivalója marad.
Mit hozott mégis az általános tanítás?
- A döntés bátorságát. Az adapter mindenhol több esetet dönt el. A termékpárosításban és az eszközválasztásban, ahol van jó válasz, pontosan is.
- Az „egyik sem” esetek egyik típusát a számlaellenőrzésben. Azt, hogy a felsorolt tételsorok közül egyik sem hibás, a tanítás nélküli modell 1 %-ban ismeri fel, az adapter 84 %-ban. Azt, hogy a döntéshez szükséges adat hiányzik a számláról, az adapter csak kicsit jobban ismeri fel: 50 helyett 58 %-ban.
- Nem vette át a régi, hibás címkéket. Az előző cikk feladatspecifikus eszközválasztó adaptere ott, ahol a forrásadatkészlet címkéit kijavítottuk, magabiztosan a régi, hibás címkét adta vissza (51 elemből 26–29-szer). Az általános adapter nagyjából annyiszor adja a régi címkét, mint a tanítás nélküli modell: 12–15-ször a 13-mal szemben. Igaz, az eszközválasztás most nem is szerepelt a tanításában.
- Az angol tanítóanyag a magyar eszközkéréseken segített. Ez egy előre rögzített mellékkérdés eredménye: az eszközválasztás magyar részén az angol anyaggal tanított változat rangsora jobb, mint az angol negyed nélkül tanítotté (egy-egy tanítási ismétlés). Ugyanez az angol anyag a termékpárosításban rontott a rangsoron, a számlaellenőrzésben nem változtatott. (Az angol kéréseknél fordított az irány, lásd fentebb.)
Közzététel és a következő lépés
A negatív eredményekről ritkán olvasni, pedig ugyanannyit tanítanak. Ezért közzétesszük:
- az adaptert mindhárom tanítási ismétléssel: k3dani/Qwen3.6-35B-A3B-hu-general-decision-lora-negative-result;
- a tanító- és a validációs adatot licenccsoportonként: k3dani/hu-general-decision-mix.
A modellkártya első bekezdése egyértelműen leírja, hogy ez kutatási melléktermék, és döntésre nem való. A Decision Indexen (a döntési modellek nyilvános összehasonlító tesztjén) nem futtattuk, és a nyílt JEV-35B döntési modellel sem vetettük össze. Ha valaki megteszi, örömmel vesszük az eredményt.
A következő kör vázlata megvan: külön tanítható döntési fej, az „egyik sem” kimenet típusokra bontása és a JEV-35B mérése a saját tesztjeinken. Egyelőre azonban itt megállunk.
Összefoglalva
Egy sok feladaton tanított adapter nem hozza el a feladatspecifikus adapterek nyereségét az ismeretlen feladatokra. A döntés bátorságát átviszi, az „egyik sem” felismerését nem, és ebből magabiztos hibák lesznek.
- Azonos pontosság mellett is mérj. Nálunk a „több automatikus döntés” nem jobb modellből jött, hanem abból, hogy a validáción választott küszöb az ismeretlen feladatokon túl engedékeny volt.
- Ne vidd át a küszöböt egyik feladatról a másikra. A validáción választott küszöb az ismeretlen feladatokon 87–91 %-os pontosságot adott a 95 helyett.
- Az „egyik sem” felismeréséhez a célterületről hozz címkézett mintát. Ez szerintünk területspecifikus tudás, az általános tanítás nem hozza magával; a következő körben ezt vizsgálnánk.
- Ne becsüld alá a tanítás nélküli, kalibrált modellt. A termékpárosításban és az eszközválasztásban, ahol van jó válasz, a küszöb fölötti döntései már eleve 99,5–99,7 %-ban helyesek.
- Rögzítsd előre, mi számít bukásnak. Utólag könnyű lett volna a több automatikus döntést sikernek nevezni.
A mérés egy előre regisztrált kör volt: a hipotéziseket, a végpontokat és a döntési szabályokat 2026. október 14-én rögzítettük, az összehasonlító eredmények megtekintése előtt. Modell: Qwen3.6-35B-A3B-FP8, vLLM 0.30, NVIDIA GB10; LoRA r16, három tanítási ismétlés; 17 500 tanítóelem. Teszt: 4524 + 7416 + 2200 pontozott elem a tanításból kihagyott három csoportban; a küszöböt 95 %-os célpontossághoz, egyoldali Clopper–Pearson-szabállyal választottuk; klaszteres bootstrap 10 000 ismétléssel. A hibák forrás szerinti bontása leíró, a kétlépcsős döntés és az angol tanítóanyagnak az angol kérésekre gyakorolt hatása feltáró elemzés; mindhárom utólagos. A protokoll, a kód és az összesített eredmények a docai-evals repóban, az adapter és az adat a Hugging Face-en vannak.