Hol érdemes tanítani a modellt?
Ugyanaz a döntési adapter két feladaton: az egyiken 13,7 ponttal több sort automatizál, a másikon rosszabb, mint a tanítás nélküli modell.
Október 5-én a döntési modellekről írt cikkünk végén megígértük, hogy kipróbáljuk a saját ötletünket: döntési adaptert a már betöltött modellünkhöz. Azt is megírtuk, hogy ha nem működik, arról is beszámolunk. Most mindkettő teljesült. Ugyanaz a kis adapter az egyik feladaton egyértelműen nyert, a másikon rosszabb lett, mint a tanítás nélküli modell.
A két eredményből derült ki az, ami szerintünk a legfontosabb: hol érdemes egyáltalán tanítani. Ez a rövid változat; a hosszú, módszertannal és korlátokkal, a Kutatás rovatban van.
Mit próbáltunk ki
A Sparkon, vLLM alatt naponta fut nálunk egy Qwen3.6-35B-A3B modell. Ehhez tanítottunk egy kis LoRA-adaptert, amely a chat helyett egyetlen döntést ad: a felkínált 2–10 lehetőség betűjelét, vagy azt, hogy egyik sem. A válasz mellé valószínűség is jár, erre lehet küszöböt tenni: ha a modell nem elég biztos, a döntés emberhez kerül.
A mérce mindkét feladaton ugyanaz volt: hány esetet visz automatikusan a rendszer, ha a besorolások 95 %-ának helyesnek kell lennie. Az összevetés alapja nem a nyers modell volt, hanem ugyanaz a modell tanítás nélkül, gondosan kalibrálva. Ilyenkor a lehetőségeket négyféle sorrendben kérdezzük meg, az eredményt átlagoljuk, és a valószínűségeket egy külön adathalmazon igazítjuk. Ez olcsó, és tanítás nélkül ennél jobbat nem tudunk kihozni a modellből.
A siker feltételeit mindkét körben a mérés előtt rögzítettük, és azt is, mi történik, ha az adapter elbukik.
Számlasor → cikk: nyert
Az első feladat a beszerzési számlák tételsorainak cikktörzshöz rendelése. A számlasorhoz a rendszer jelölt cikkeket ad, és a modellnek ki kell választania a jót, vagy azt kell mondania, hogy egyik sem az. A mérés szintetikus adaton futott, amelyet egy valós vállalkozás aggregált beszerzési profilja alapján generáltunk.
| kalibrált alapmodell | döntési adapter | |
|---|---|---|
| automatikusan besorolt sorok, 95 %-os célnál | 61,6 % | 75,2 % |
| ugyanez 16 új szállítónál | 56,8 % | 76,3 % |
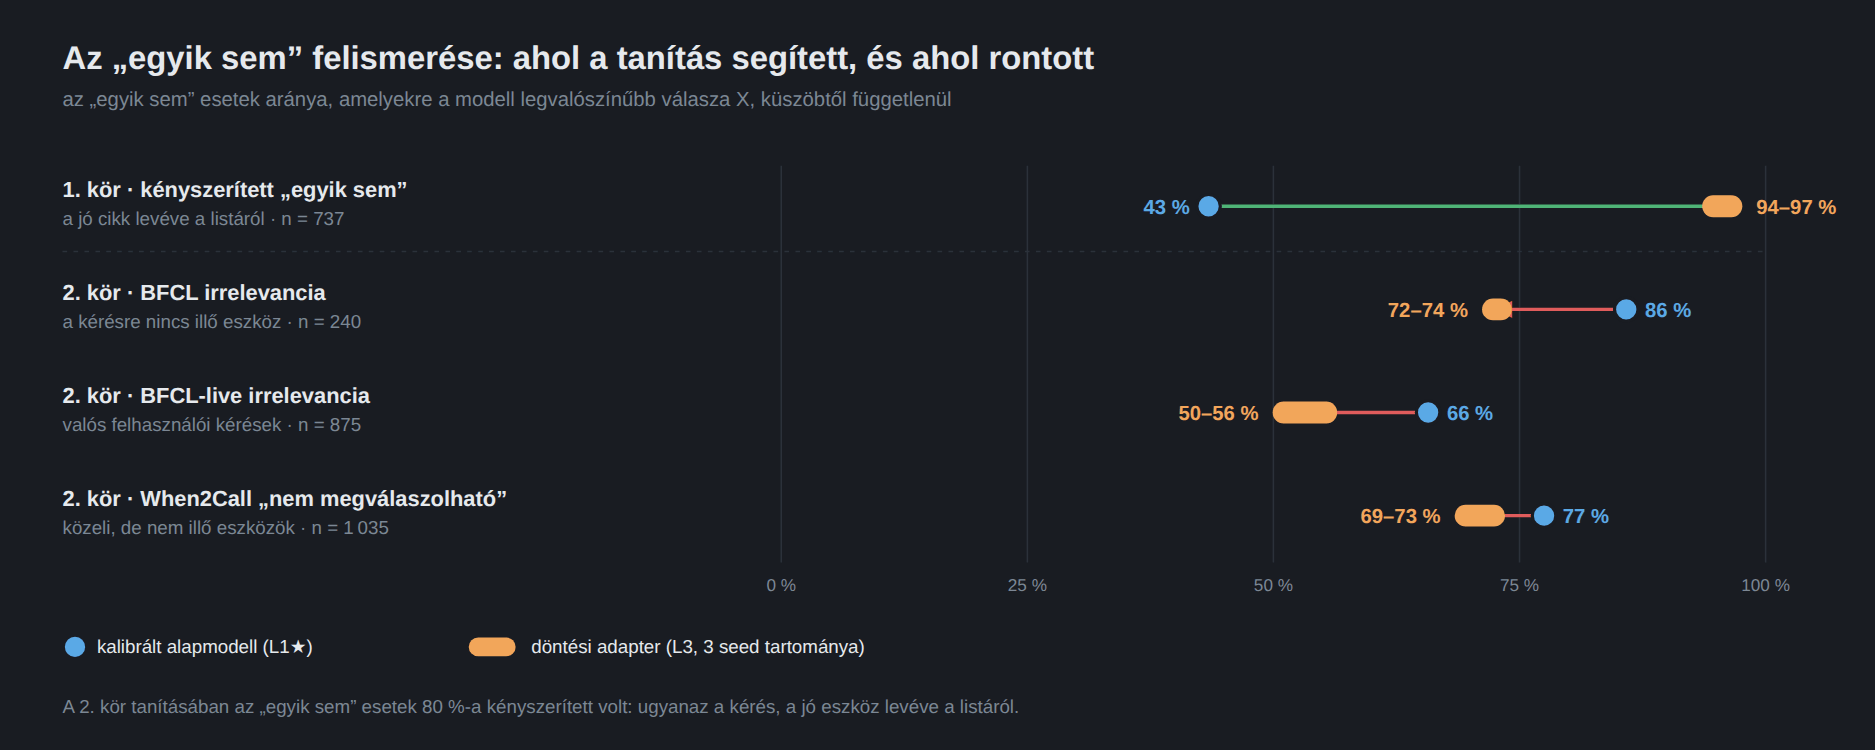
| „egyik sem” esetek felismerése | 43 % | 96 % |
| hibaarány 70 %-os lefedettségnél | 4,8 % | 0,4–0,5 % |
A nyereség +13,7 százalékpont, új szállítóknál +19,5 pont. Szinte teljes egészében abból jön, hogy az adapter felismeri, ha a jó cikk nincs a listán. A tanítás nélküli modell ezekben az esetekben választott valamit a felkínált cikkek közül. Az adapter és az adatkészlet publikus a Hugging Face-en.
Eszközválasztás: rosszabb lett
A második feladat: a kérés alapján melyik eszközt hívja az ügynök, vagy egyiket se. Ugyanaz a recept, publikus adaton (BFCL, When2Call, xLAM, a MASSIVE magyar része) és egy saját, 62 eszközös katalógus magyar kéréseivel. A teszt 10 013 elemből állt.
| kalibrált alapmodell | döntési adapter | |
|---|---|---|
| automatikusan besorolt kérések | 71,7 % | 76,7 % |
| ebből helyes (cél: 95 %) | 88,2 % | 84,0 % |
| hibaarány 50 %-os lefedettségnél | 4,9 % | 7,3–8,0 % |
| „nincs illő eszköz” felismerése | 76,2 % | 67,3 % |
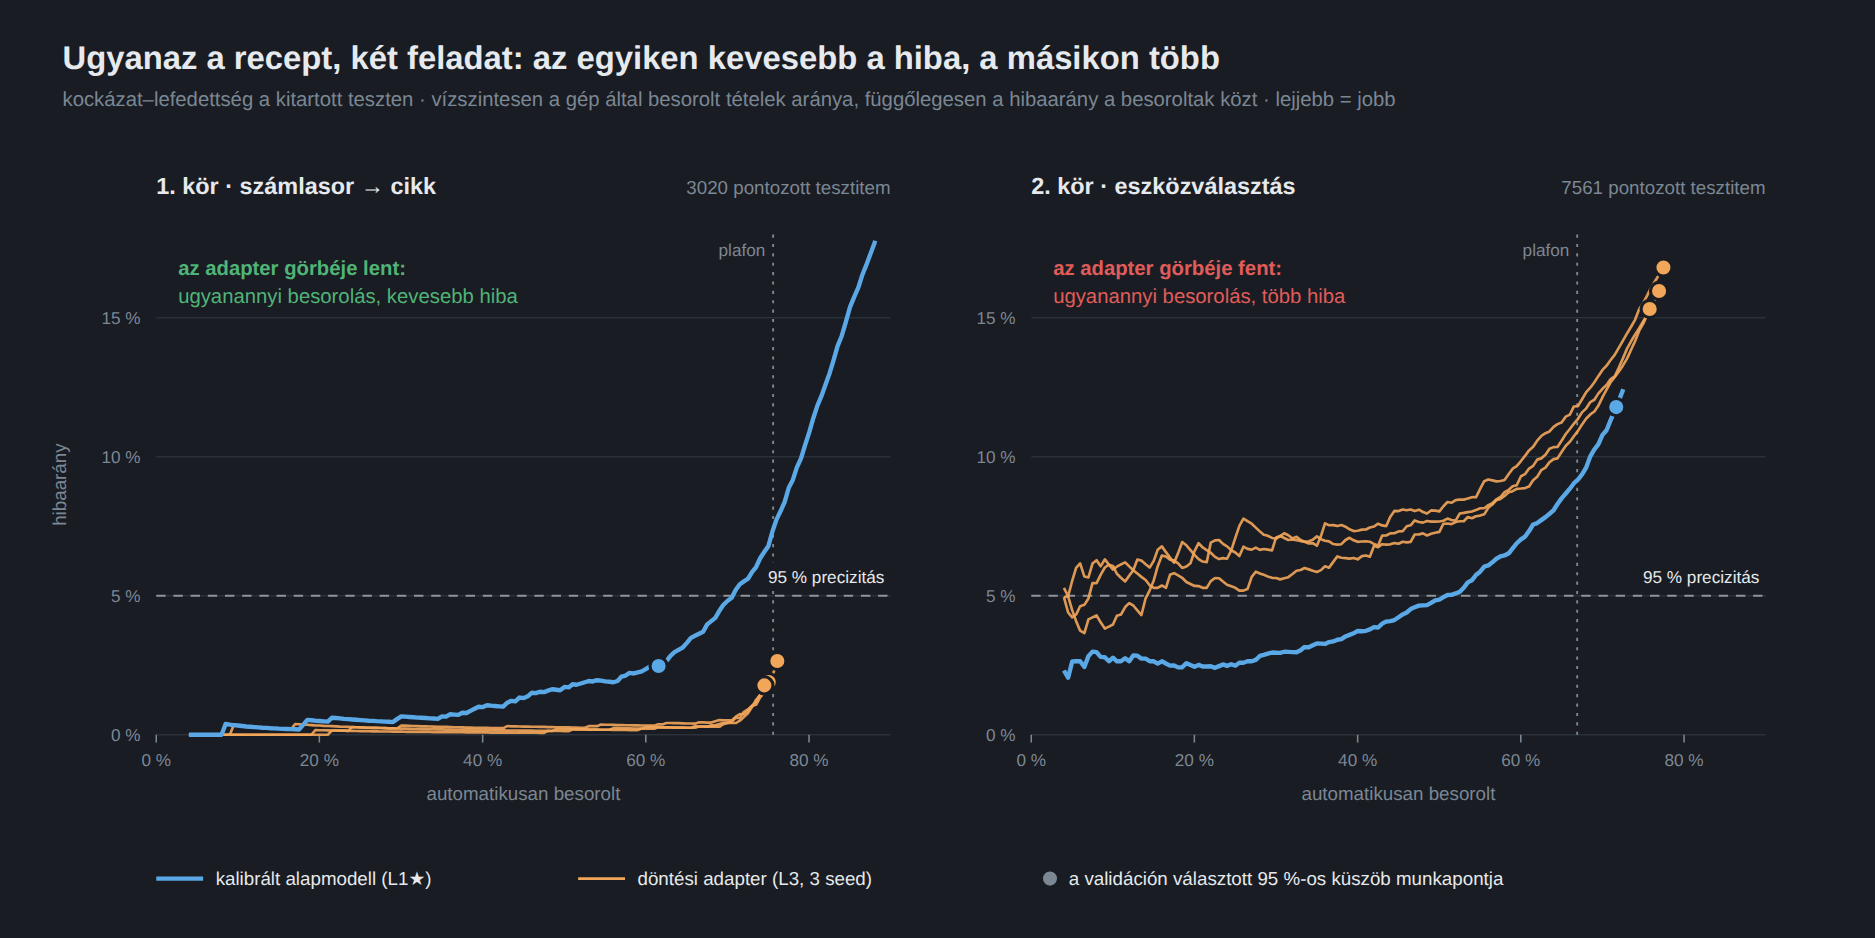
Az adapter több kérést sorolt be, de rosszabb pontossággal, és a „nincs illő eszköz” eseteket ritkábban ismerte fel. Azonos lefedettségnél a hibaaránya is magasabb volt. A sikerfeltétel a mérés előtt rögzített szabály szerint nem teljesült.
A táblázatban van egy második, kellemetlen sor is. A 95 %-os célt a tanítás nélküli modell sem tartotta: a küszöböt egy olyan adathalmazon választottuk, amelynek „nincs illő eszköz” esetei mások voltak, mint a teszté.
Egy ábrán a két feladat: minél lejjebb fut a görbe, annál kevesebb a hiba ugyanannyi automatikus besorolásnál.
Miért fordult meg az eredmény?
Az első ok: az eszközválasztásban nem volt mit nyerni. Ha volt illő eszköz, a tanítás nélküli modell már 93–100 %-ban besorolta a kérést, 97–100 %-os pontossággal. Az alapmodellt nyilvánvalóan sokat tanították eszközhívásra, számlasorok cikkhez rendelésére viszont nem. Az első feladaton a tanítás nélküli modellnek volt hová fejlődnie, a másodikon már a plafon közelében járt.
A második ok: a tanítás rossz típusú „egyik sem” esetet mutatott. A tanító „nincs illő eszköz” esetek 80 %-a mesterséges volt: ugyanaz a kérés, csak a jó eszközt levettük a listáról. Ebből a modell azt tanulta meg, hogy ha van hasonló eszköz, hívja meg. A tesztben viszont valódi, irreleváns kérések jöttek, és mellettük közeli, de nem illő eszközök álltak. Az első feladaton a teszt „egyik sem” esetei pontosan ugyanolyanok voltak, mint a tanításéi, ezért ott ez nem okozott gondot.
Egy harmadik jelenség is előjött: a magyar kéréseknél az adapter a forrásadatkészlet néhány hibás címkéjét is megtanulta. Ahol mi a címkét kijavítottuk, ott magabiztosan a régit adta.
A puha célokkal desztillált modell sem jobb
Kézenfekvő ellenvetés, hogy a hiba a tanítás módjában van: ha a modell egy tanármodell teljes valószínűség-eloszlását tanulja, talán megmarad a kalibrációja. Erre van egy publikus próba. A JEV-27B a zárt Jev modell nyílt, desztillált változata (az AutoTrust AI kiadása, nem a TypeSafe-é), és a készítői közzétették a válaszvalószínűségeit egy nagy benchmarkon. Ugyanazokon a When2Call-elemeken vetettük össze a modelleket.
| szétválasztás (AUROC) | hamis hívás 95 % helyes hívás mellett | |
|---|---|---|
| kalibrált alapmodell | 0,964 | 14,1 % |
| a mi döntési adapterünk | 0,945–0,959 | 15,7–17,3 % |
| JEV-27B | 0,949 | 37,3 % |
A JEV-27B a mi adapterünk szintjén van, és mindkettő elmarad a tanítás nélküli, kalibrált modelltől. Ez nem a JEV hibája: a modellkártyája mást mér, a tanármodellhez való hűséget és a pontosságot rögzített opciókészleten. Azt viszont mutatja, hogy a „nincs illő eszköz” csapdát a puha célok önmagukban nem védik ki.
Mit döntöttünk
A számlasorok cikkhez rendelésénél a döntési adapter valódi nyereség, ott marad. Az eszközválasztó adaptert nem publikáljuk: a teszten a kalibrált alapmodell jobb, és aki letöltené, rosszabbul járna vele. A DocAI-ban az eszközválasztáshoz a kalibrált kiolvasás megy tovább, adapter nélkül. Ez egyébként a modell beépített eszközhívását is veri: azonos lefedettség mellett 5,7 ponttal pontosabb.
Egy jó hírt is hozott a mérés: ugyanazon a vLLM-példányon két adapter egyszerre betöltve, párhuzamos terhelés mellett is ugyanazt adja, mint külön. Feladatonként cserélhető adapterekkel tehát egyetlen modellpéldány is kiszolgálhat több döntést.
Összefoglalva
A finomhangolás nem eleve javítás. Ugyanaz a recept, ugyanazon a modellen, az egyik feladaton 13,7 pontot hozott, a másikon rontott. A különbség nem a receptben volt, hanem abban, hol volt gyenge a modell, és mit látott a tanítás.
- Előbb a tanítás nélküli, kalibrált modellt mérd meg. Ez a mérce, nem a nyers modell. Nálunk ez a lépés a modell beépített eszközhívását is verte.
- Ott taníts, ahol a modell gyenge. Ahol a tanítás nélküli modell már a plafon közelében jár, ott a tanítás inkább árt, mint használ.
- Az „egyik sem” esetek a tanításban olyanok legyenek, mint élesben. A mesterségesen előállított „nincs illő” eset mást tanít, mint a valódi.
- A küszöböt az éles forgalomhoz hasonló adaton válaszd. Más adaton választva a 95 %-os cél a tanítás nélküli modellnél is 88 %-ra esett.
- Rögzítsd előre, mi számít sikernek. A negatív eredményből tanultuk a legtöbbet, de csak azért, mert előre leírtuk, mit tekintünk bukásnak.
A mérés két előre regisztrált kör: a protokollokat 2026. október 3-án és 8-án, a teszt érintése előtt rögzítettük. Modell: Qwen3.6-35B-A3B-FP8, vLLM 0.30, NVIDIA GB10; adapterenként három tanítási ismétlés. A számlasoros kör szintetikus adaton futott (3534 + 2107 tesztelem), az eszközválasztásos publikus adaton és saját katalóguson (10 013 tesztelem). A JEV-27B számai a készítők közzétett, elemenkénti valószínűségeiből és a benchmark újraépített címkéiből származnak; a modellt nem futtattuk. A teljes módszertan, a konfidencia-intervallumok és a korlátok a kutatási jelentésben, a kód és az eredmények a docai-evals repóban vannak.