Kutatási jelentés
Hol érdemes döntésre tanítani a modellt?
Ugyanaz a recept, ugyanaz a kiszolgált modell, két feladat, két előre regisztrált mérés — és ellentétes eredmény. Egy kis döntési LoRA a magyar számlasorok cikkhez rendelésében 13,7 ponttal több sort automatizál 95 %-os precizitás mellett, az eszközválasztásban viszont rosszabb, mint a tanítás nélküli, kalibrált alapmodell. A különbség nem a receptben van, hanem abban, hol volt gyenge az alapmodell, és milyen „egyik sem” esetet látott a tanítás.
Egy már kiszolgált chat-modellt (Qwen3.6-35B-A3B, FP8, vLLM) tanítottunk egy kis LoRA-adapterrel arra, hogy egyetlen címketokennel döntsön a felkínált opciók közt, vagy mondja azt, hogy egyik sem. A mérce mindkét feladaton ugyanaz volt: hány esetet visz automatikusan, ha a besorolások 95 %-ának helyesnek kell lennie, és ezt összevetettük azzal, amit a tanítás nélküli alapmodell ad, ha a válaszvalószínűségeit gondosan kalibráljuk. A számlasor → cikk feladaton az adapter nyer: +13,7 pont, új szállítókon +19,5 pont, és az „egyik sem” eseteket 43 % helyett 96 %-ban ismeri fel. Az eszközválasztásban veszít: több kérést sorol be, de a precizitása a kitartott teszten 84 %-ra esik, a kockázat–lefedettség görbéje rosszabb az alapmodellénél, és a valódi irrelevanciát 8,9 ponttal ritkábban ismeri fel. A nem-X eszközválasztásban az alapmodell már tanítás nélkül is szinte hibátlan volt, a nyerhető rész az „egyik sem” lett volna — és a tanítás pont ott rontott, mert más típusú „egyik sem” esetet látott, mint amilyennel a teszt jött. Egy publikus, puha célokkal desztillált döntési modell (JEV-27B) ugyanezeken az itemeken ugyanígy elmarad a kalibrált alapmodelltől.
| kérdés | ítélet | mire épül |
|---|---|---|
| Számlasor → cikk · többet automatizál-e a döntési adapter a kalibrált alapmodellnél? | Igen. | lef@95 0,616 → 0,752, Δ +13,7 pont [4,8; 21,0]; AURC 0,0273 → 0,0018 |
| Új szállítók · általánosít-e? | Igen. | 16 csak tesztben szereplő szállító: +19,5 pont [10,2; 29,2], mind a 16-on pozitív |
| Eszközválasztás · ugyanez a recept nyer-e? | Nem. | precizitás 0,84 a 0,95-ös célnál (bukás); AURC +0,028 [0,022; 0,034] az alapmodell javára |
| Miért · hol romlik? | Az „egyik sem” eseteken. | X-fedés −8,9 pont [−11,4; −6,3]; a nem-X itemeken 98–100 % besorolás 97–100 % precizitással |
| Puha célok · elkerüli-e ezt egy desztillált modell? | Nem. | hívás/nem hívás AUROC ugyanazon 2328 itemen: alapmodell 0,964, adapter 0,945–0,959, JEV-27B 0,949 |
| Kiszolgálás · mehet-e két adapter egy példányon, párhuzamos terhelés mellett? | Igen, egy kitétellel. | top-címke-egyezés a zaj-alapon belül, soros és c = 16 forgalomnál; a LoRA-támogatás bekapcsolása a LoRA nélküli kérések ~6 %-át átbillenti |
Minden állítás egy modellen, egy kvantáláson, egy motoron mért. A korlátok a 11. fejezetben; a kód, a protokollok és az eredmények a mellékletben.
A DocAI-ban két helyen kell gépnek döntenie úgy, hogy tudnia kell, mikor ne döntsön: a beszerzési számlák tételsorainak cikktörzshöz rendelésénél, és amikor egy ügynök a kérés alapján eszközt választ. Mindkét helyen ugyanaz a kérdés: ha a modell bizonytalan, a sor ne könyvelődjön automatikusan, hanem menjen emberhez. Ehhez a modellnek kalibrált valószínűség kell, nem csak válasz. Kézenfekvő ötlet egy kis döntési adapter ugyanarra a példányra, amelyik a chatet is kiszolgálja. Az első kör ezt igazolta, a második kör azt kérdezte, átvihető-e a recept egy második feladatra. Nem vihető át — és ebből a negatív eredményből tanultuk meg, hol érdemes egyáltalán tanítani.
1. fejezetA kérdés: döntés tartózkodással, ugyanazon a példányon
Mindkét kör kutatási kérdése ugyanaz volt: egy már kiszolgált chat-modell egy kis
döntési adapterrel kalibráltabb és lefedettebb döntést ad-e, mint a saját, tanítás
nélküli válaszvalószínűségeinek gondos kalibrálása? A döntés formája egyetlen
token: a modell a felkínált 2–10 opció betűjelét adja (A–J),
vagy X-et, ha egyik sem illik. A címketokenekre szűkített valószínűség a
döntés bizonyossága; erre tehető egy küszöb, ami eldönti, mikor dönt a gép és mikor az
ember.
A hipotéziseket, a cáfolati kritériumokat, az elsődleges végpontokat, a statisztikai eljárást és a publikálási döntési szabályt mindkét körben a mérés előtt rögzítettük: az első körben 2026. október 3-án, a másodikban október 8-án, mielőtt a tesztet bármelyik kar érintette volna. A publikálási szabály azt is előre kimondta, mi történik, ha az adapter elbukik: akkor az adapter nem publikus, a negatív eredmény igen.
2. fejezetKét feladat, egy recept
| 1. kör: számlasor → cikk | 2. kör: eszközválasztás | |
|---|---|---|
| döntés | egy magyar beszerzési számlasorhoz melyik cikk a 2–10 jelölt közül, vagy egyik sem | egy kéréshez melyik eszköz a 2–10 jelölt közül, vagy egyik sem |
| adat | szintetikus: egy valós vállalkozás aggregált beszerzési profilja alapján kitalált cikktörzs (3514 cikk) és szállítók | publikus: xLAM, When2Call, BFCL, MASSIVE magyar része, plusz egy saját, 62 eszközös általános katalógus generált magyar kérésekkel |
| teszt | 3534 item négy rétegben (3020 pontozott) + 2107 item 16 új szállítóval | 10 013 item; a pontozott pool 7561 item öt rétegből |
| „egyik sem” a tesztben | 25 %; zömmel kényszerített (a jó cikket levettük a listáról) | 33 %; zömmel valódi irrelevancia (BFCL-live, When2Call) |
| „egyik sem” a tanításban | ugyanazzal a kényszerítéssel, mint a tesztben | 80 % kényszerített, 20 % természetes (499 When2Call, 255 csevegés) |
| recept | LoRA r16 az attention- és a GDN-vetítéseken, valamint a megosztott szakértő MLP-jén (a routolt szakértőkön nincs LoRA), 1 epoch, CE a jelen lévő címkékre + 0,5·Brier, ε = 0,05; a 2. körben 30 % opció-permutációval; 3 seed; BF16-on tanítva, az FP8 checkpointon kiszolgálva | |
A tesztcímkéket mindkét körben átnéztük. Az első körben két független LLM-bíráló előszűrt, utána rétegzett emberi átnézés jött (424 item); a maradék zaj 0,40 % (felső 95 %-os korlát 1,36 %). A második körben a magyar rétegek címkéit egy nagy modell nézte át teljesen, emberi vak szúrópróbával auditálva (300 változatlan + 70 gépi javítás): a becsült maradék zaj 1,2 % (felső korlát 2,4 %), a gépi javítások 87 %-a megerősítve. Az előre rögzített 2 %-os kaput ez nem teljesíti; korlátként jelentjük.
3. fejezetA létra, a mérőszámok és a protokoll
Minden kar ugyanazon a vLLM-példányon fut, így a páros különbségekből a példányzaj kiesik. A létra fokai:
- L0 · nyers kiolvasás. Az alapmodell válaszának valószínűsége a címketokenekre szűkítve.
- L1★ · kalibrált kiolvasás. Ugyanez négy opciósorrend átlagaként, a val-on illesztett temperature-rel. Tanítás nélkül ez a legjobb, amit a modellből ki lehet hozni; ez az összevetés alapja.
- L3 · döntési LoRA. A fenti recept, temperature-rel kalibrálva.
Két saját mérőszám, mindkettő előre definiálva:
- lef@95 (lefedettség 95 %-os precizitás mellett): a pontozott itemek aránya, amelyeket a kar egy τ küszöb fölött cikkhez vagy eszközhöz rendel. A τ a val-on választódik: a legkisebb küszöb, amely fölött a besorolások precizitásának egyoldali 95 %-os Clopper–Pearson alsó korlátja legalább 0,95. Felső korlátja a plafon, a nem-X itemek aránya. Ha a teszten elért precizitás 0,93 alá esik, az precizitás-bukás.
- AURC: a kockázat–lefedettség görbe alatti terület; minél kisebb, annál jobban rangsorolja a kar a saját döntéseit bizonyosság szerint.
Statisztika: klaszterezett, hierarchikus bootstrap (seed × klaszter), 10 000 ismétlés, a val újramintavételezésével és a τ minden ismétlésben újraválasztva; Holm-korrekció a társ-elsődleges végpontokra.
4. fejezetSzámlasor → cikk: ahol az alapmodell gyenge
| kar | lef@95 | elért precizitás | AURC | ECE | X-precizitás / X-fedés |
|---|---|---|---|---|---|
| L0 nyers | 0,596 | 0,957 | 0,0370 | 0,048 | 0,850 / 0,385 |
| L1★ kalibrált | 0,616 | 0,975 | 0,0273 | 0,043 | 0,891 / 0,434 |
| L3 döntési LoRA | 0,752 [0,745–0,761] | 0,979 | 0,0018 | 0,010 | 0,945 / 0,957 |
A négy tesztréteg együtt, 3020 pontozott item; a plafon 0,756. Az L3 a három seed átlaga, zárójelben a tartomány.
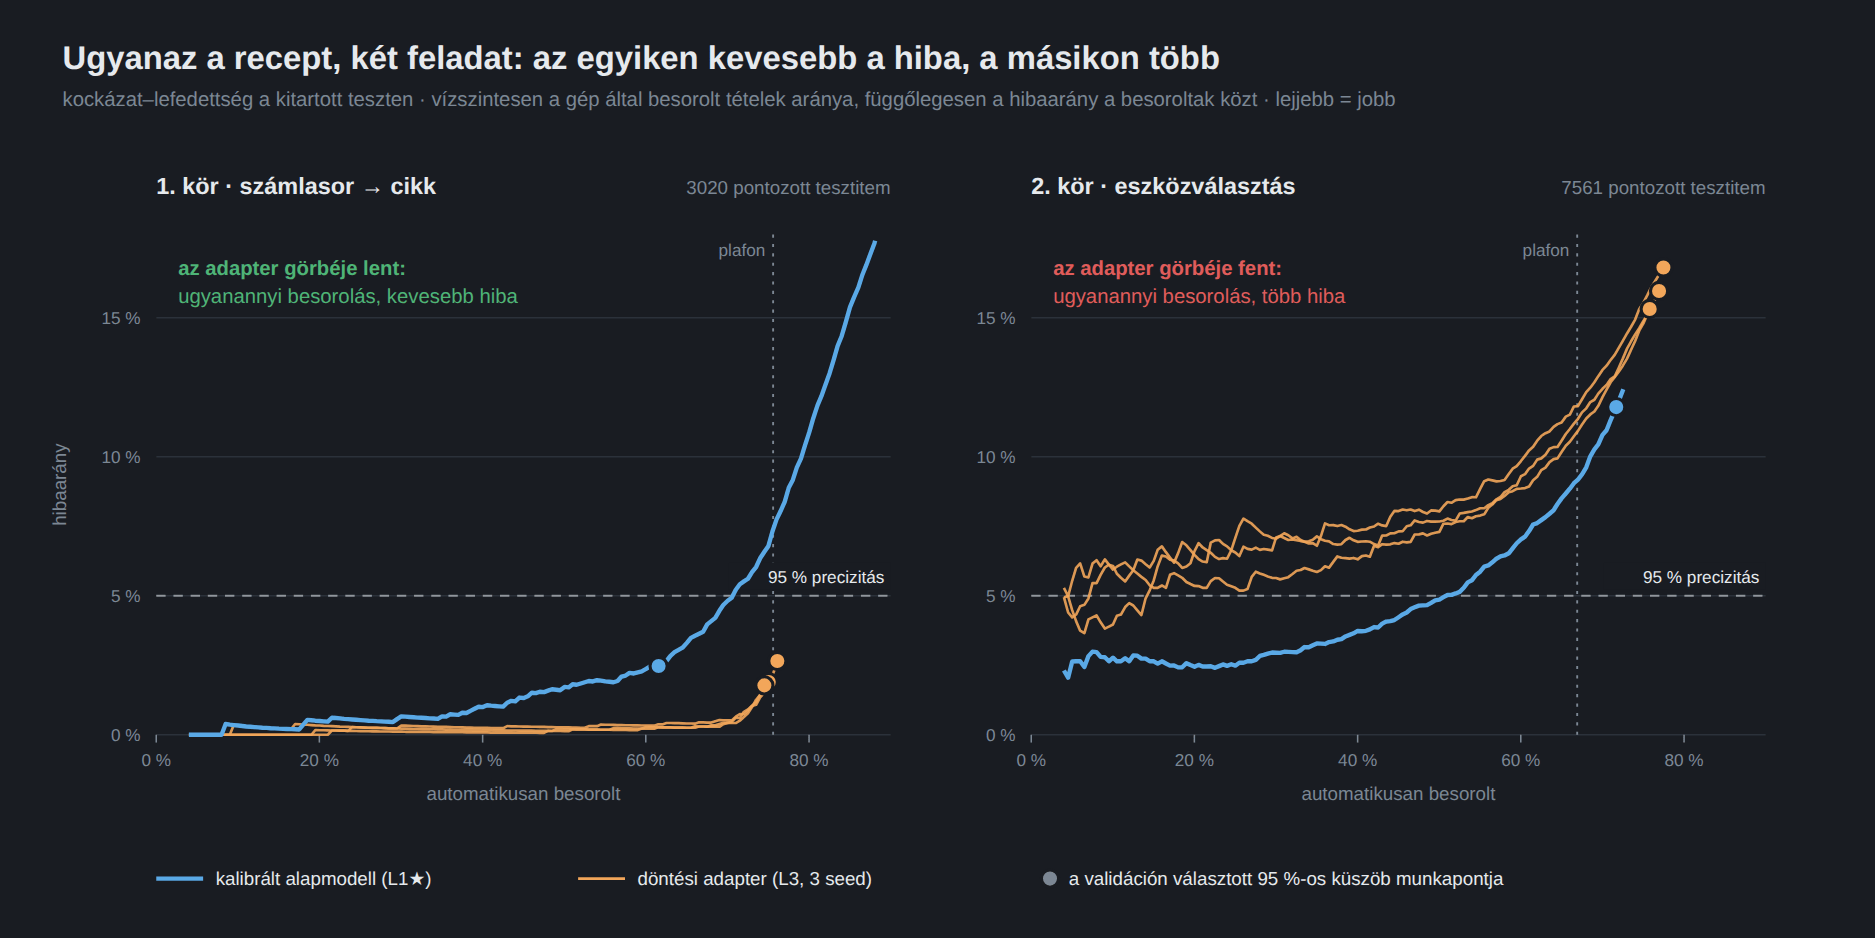
- A nyereség +13,7 pont [4,8; 21,0], az AURC −0,0255 [−0,0300; −0,0213]. Az L3 gyakorlatilag a plafonon áll.
- A nyereség az „egyik sem” felismeréséből jön. Az L1★ hibái 95 %-os célnál 46-ból 42 esetben tévesen besorolt „egyik sem” sorok; rossz cikket alig választ. Az X-fedés 0,43-ról 0,96-ra nő.
- Kockázat azonos lefedettségen: 70 %-os lefedettségnél a besorolások hibaaránya 4,8 %-ról 0,4–0,5 %-ra csökken.
- Általánosít: a tanításból kitartott kategóriaágakon +9,8 pont [1,7; 15,5], 16 csak tesztben szereplő szállítón +19,5 pont [10,2; 29,2], mind a 16 szállítón pozitív nyereséggel.
- Az előny mérete a valós „egyik sem” aránytól függ: a teszt 25 %-os X-arányán +13,7 pont, 10 %-os X-arányra ritkítva +3,5 pont.
Az adapter és az adatkészlet publikus:
Qwen3.6-35B-A3B-invoice-decision-lora és
hu-invoice-catalog-decisions.
5. fejezetEszközválasztás: ahol az alapmodell erős
| kar | lef@95 (/plafon) | elért precizitás | AURC | ECE | X-precizitás / X-fedés |
|---|---|---|---|---|---|
| L0 nyers | 0,684 (1,02) | 0,893 ⚠ | 0,0333 | 0,056 | 0,912 / 0,762 |
| L1★ kalibrált | 0,717 (1,07) | 0,882 ⚠ | 0,0331 | 0,023 | 0,919 / 0,762 |
| L3 döntési LoRA | 0,767 (1,15) [0,758–0,775] | 0,840 ⚠ | 0,0609 | 0,088 | 0,964 / 0,673 |
| natív tool calling | hívásarány 0,674 | 0,850 | — | — | — / 0,735 |
A pontozott pool 7561 itemén (BFCL, BFCL-live, When2Call, magyar MASSIVE, katalógus); a plafon 0,669. ⚠ = precizitás-bukás. Az 1-nél nagyobb lefedettség/plafon arány azt jelenti, hogy a kar „egyik sem” itemeket is eszközhöz rendel.
- Az elsődleges hipotézis cáfolt, mindkét végponton. A lefedettségben az L3 +4,9 pontot [3,6; 6,6] mutat, de a precizitása mindhárom seednél a bukási határ alatt van (0,83–0,85). Az AURC-ben szignifikánsan az alapmodell jobb (+0,028 [0,022; 0,034]).
- Közös lefedettségre vágva is. Az AURC a kar saját besorolásain fut, így a többet besoroló kar hosszabb görbét kap. Ezért ugyanazon lefedettségen is összevetettük: 50 %-os lefedettségnél az alapmodell hibaaránya 4,9 %, az L3-é 7,3–8,0 %.
- A natív tool callingot mindkettő veri a natív munkapontján (az L3 +3,4 pont precizitás azonos lefedettségen, +7,4 pont lefedettség azonos precizitáson) — de ezt az előnyt főleg a kalibrált kiolvasás adja, nem az adapter: az L1★ ugyanott +5,7, illetve +5,1 pont.
- Egyik kar sem tartja a 95 %-ot. A val-on választott küszöb a teszten az alapmodellnél is 88 %-os precizitást ad: a val „egyik sem” esetei (kényszerített, xLAM és MASSIVE) nem képviselik a teszt valódi irrelevanciáját.
6. fejezetMiért fordult meg: az „egyik sem” típusa
A két kör közti különbséget nem a recept magyarázza — az ugyanaz volt —, hanem az, hogy hol volt mit nyerni, és milyen „egyik sem” esetet látott a tanítás.
Ahol nem volt mit nyerni
Az eszközválasztás nem-X itemjein az alapmodell már tanítás nélkül is szinte hibátlan: a BFCL és a When2Call nem-X itemjeinek 93–100 %-át 97–100 %-os precizitással sorolja be. Az L3 itt 98–100 %-ra emeli a lefedettséget, ami alig több. Az alapmodellt kifejezetten tool callingra is tanították; számlasor → cikk besorolásra nem. Az első körben a kalibrált alapmodell lef@95-je 0,616 volt a 0,756-os plafon alatt, a másodikban a nem-X eszközválasztás már a plafon közelében járt. A tanulság: ott érdemes tanítani, ahol az alapmodell gyenge.
Ahol volt, ott rontott
| forrás (X-itemek) | n | L1★: X-fedés / besorolva @95 | L3 (3 seed): X-fedés / besorolva @95 |
|---|---|---|---|
| BFCL irrelevance | 240 | 0,858 / 0,142 | 0,717–0,738 / 0,263–0,283 |
| BFCL-live irrelevance | 875 | 0,657 / 0,331 | 0,504–0,560 / 0,432–0,482 |
| When2Call „cannot answer” | 1035 | 0,775 / 0,210 | 0,689–0,730 / 0,269–0,309 |
A precizitásesés teljes egészében az „egyik sem” itemekből jön: az L3 a valódi irrelevanciát gyakrabban rendeli magabiztosan eszközhöz. A tanítás „egyik sem” esetei 80 %-ban kényszerítettek voltak: ugyanaz a kérés, a jó eszköz levéve a listáról. Ebből a modell azt tanulta meg, hogy ha van hasonló eszköz, hívja meg. A tesztben az irreleváns kérések mellett közeli, de nem illő eszközök állnak. Az első körben a teszt „egyik sem” esetei ugyanolyan kényszerítettek voltak, mint a tanításéi — ott a modell pontosan azt tanulta meg, amivel a teszt jött.
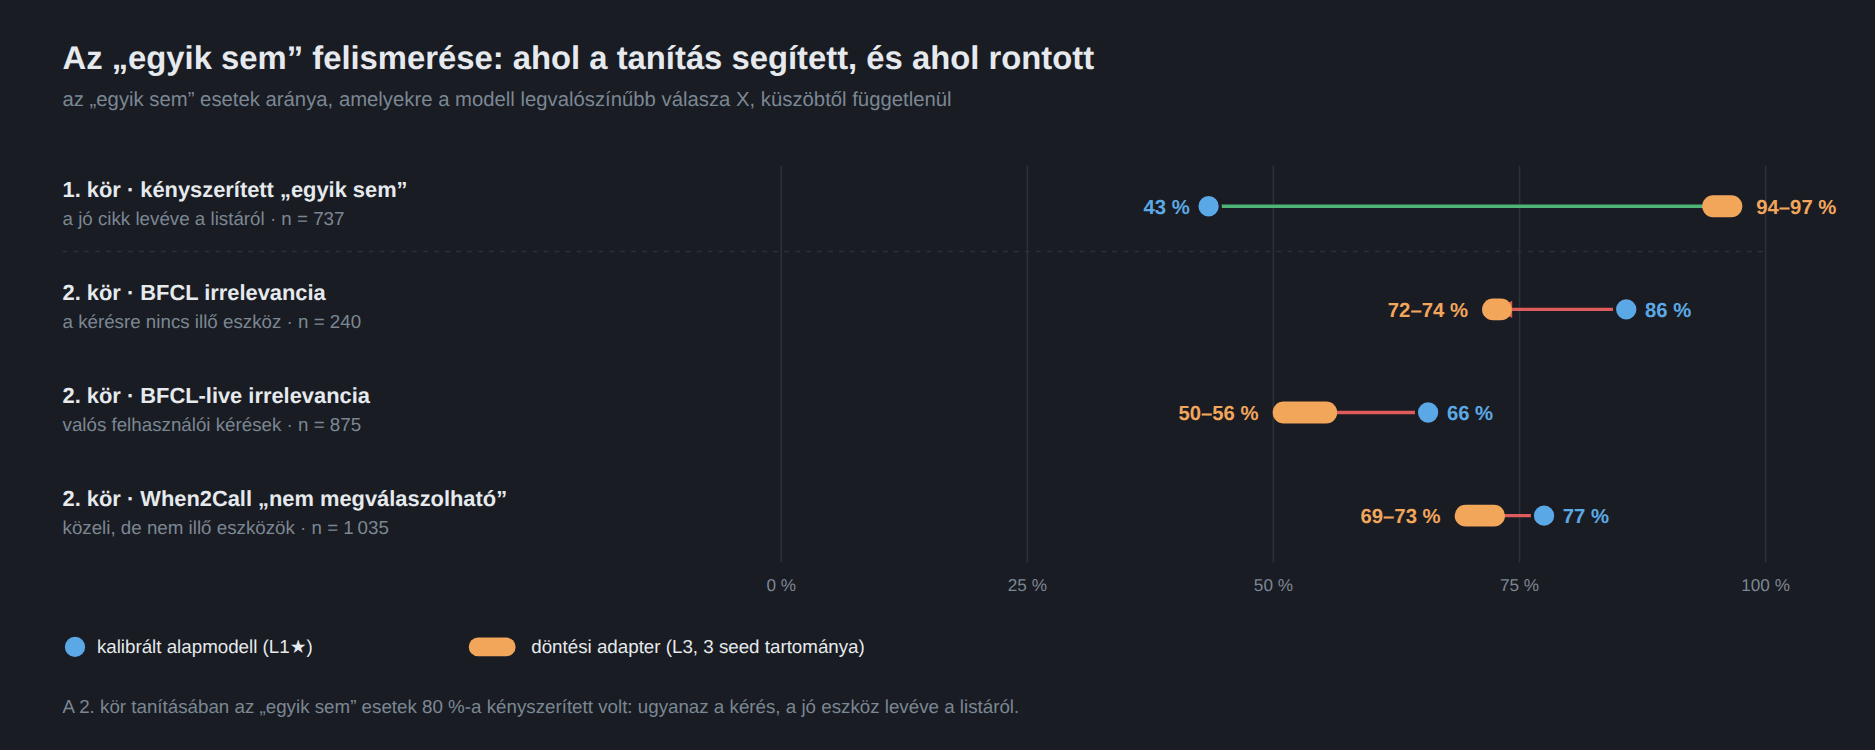
Fontos részlet: a második kör tanítása 499 When2Call-típusú valódi irrelevanciát is tartalmazott (a tanító „egyik sem” esetek 13 %-a), és a modell mégis romlott ezen a típuson. Kis arányú lefedés nem volt elég ellensúlynak.
A forrás címkézési szokásait is megtanulta
A magyar rétegben az átnézés 40 itemen javította a MASSIVE eredeti címkéjét. Ezek közül az L3 18–24-nél a régi címkét adja, mindet a küszöb fölötti bizonyossággal; az alapmodell 8-nál. Ha ezt a 40 itemet kihagyjuk, az L3 a magyar rétegen is jobb (AURC 0,0011–0,0019 az alapmodell 0,0028-ával szemben). Ez utólagos részhalmaz, ítéletet nem változtat, de mutatja a kemény címkés tanítás egyik kockázatát: a forrás konvenciói magabiztosan beégnek.
Amit utólag kipróbáltunk
- Gondolkodó mód a bizonytalanokra. A küszöb alatti itemeket az alapmodell gondolkodó módja kapta. Az oda került 1743 item 96 %-a „egyik sem” volt, és ezek 95 %-át helyesen ismerte fel — de a hibák nem ott voltak: az L3 rossz besorolásai a küszöb fölött ültek, magabiztosan.
- Kétlépcsős döntés. Ha a hívjon-e kérdést az alapmodell dönti el, és csak az eszközt választja az L3, az „egyik sem” felismerés megmarad az alapmodell szintjén, de a lefedettség csak ~1 ponttal nő (0,726 vs. 0,717). Az eszközválasztásban nem volt mit nyerni.
7. fejezetEgy publikus, puha célú modell ugyanezen
Kézenfekvő ellenvetés, hogy a kemény címkés tanítás volt a hiba: egy tanármodell teljes eloszlására desztillált adapter talán megőrzi a kalibrációt. Erre van publikus próba. A JEV-27B döntési modell (autotrust/JEV-27B) puha célokkal, 656 ezer soron tanult, és a készítői közzétették az itemenkénti valószínűségeit a Decision Index benchmarkon (jev-decision-index-results). A goldot a benchmark-kit rögzített forrásaiból építettük újra; a közölt pontosságaik mindkét általunk használt sávon pontosan visszajönnek. A JEV-27B a When2Call-t és a CLINC150-et nem látta tanításkor; a 2. körünk adaptere a When2Call tanítórészén tanult.
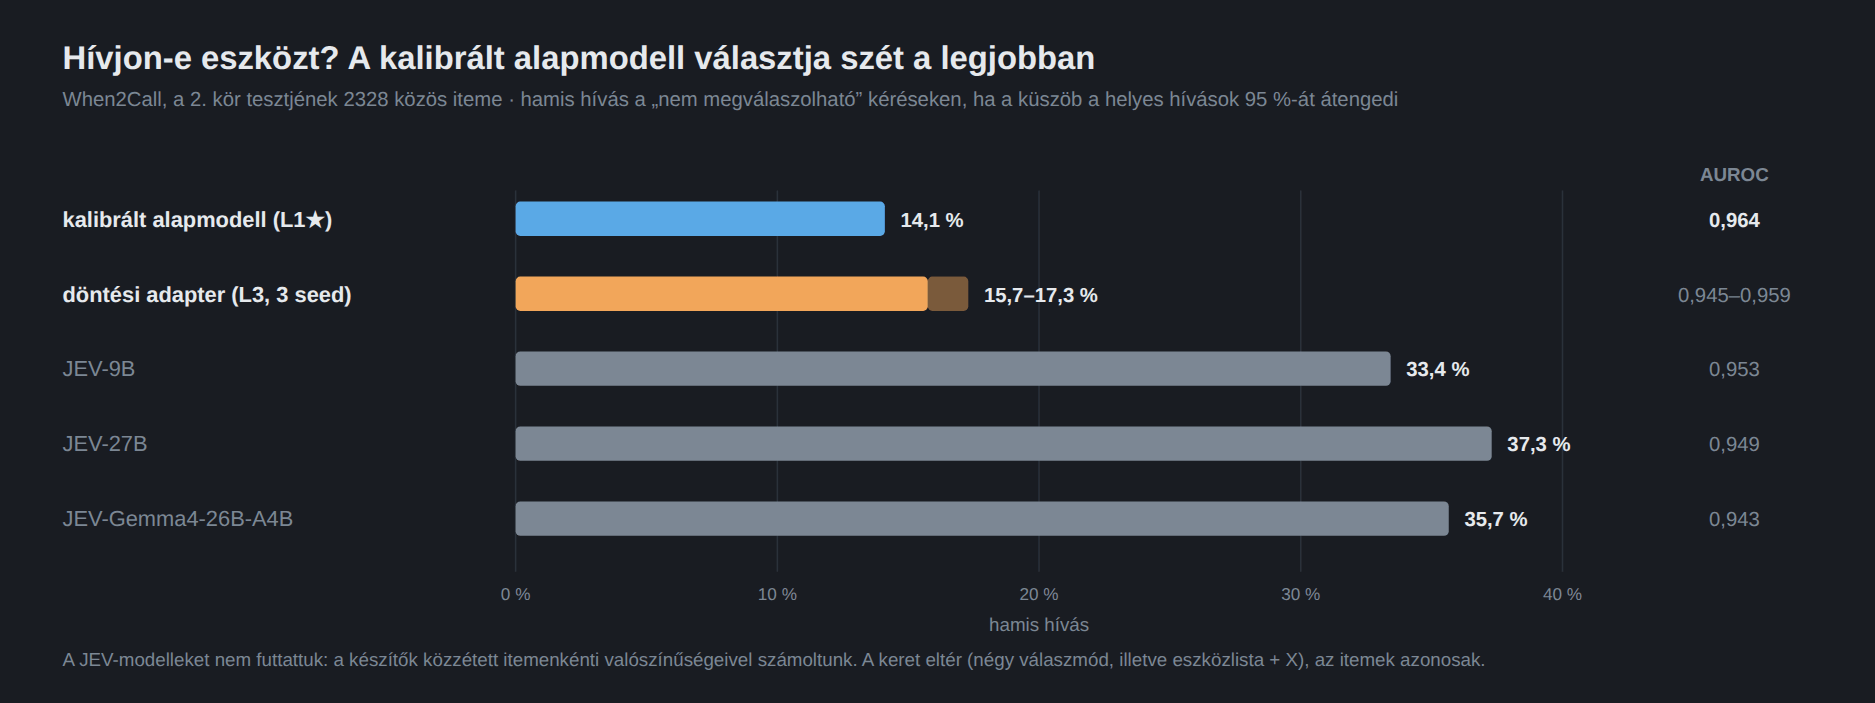
| kar | AUROC | hamis hívás 90 % helyes hívásnál | hamis hívás 95 %-nál | hívás a „cannot answer” itemeken |
|---|---|---|---|---|
| L1★ kalibrált alapmodell | 0,964 | 8,6 % | 14,1 % | 22,5 % |
| L3 döntési LoRA (3 seed) | 0,945–0,959 | 9,5–11,7 % | 15,7–17,3 % | 27–31 % |
| JEV-27B | 0,949 | 9,7 % | 37,3 % | 6,2 % |
When2Call, a 2. kör tesztjének ugyanazon 2328 itemén (1293 helyes hívás, 1035 „nincs illő eszköz”). A mi karjainknál a hívás valószínűsége 1 − P(X), a JEV-nél a tool-call válaszmód valószínűsége. A keretek eltérnek: a JEV négy válaszmód közül választ, a mi karjaink eszközlistából és X-ből; az itemek azonosak.
- A JEV-27B alacsony hívásaránya óvatosabb munkapont, nem jobb szétválasztás: a helyes hívások 13 %-át is kihagyja. Küszöbtől függetlenül (AUROC) az adapterünk szintjén van, és mindkettő elmarad a kalibrált alapmodelltől.
- CLINC150, hatókörön kívüli kérések: a JEV-27B 38 %-ban ismeri fel őket, miközben a hatókörön belüli pontossága 89 %. A Gemma-alapú testvére, amely a CLINC tanítórészét is látta, 67 %-ban.
- Következtetés: a puha cél önmagában nem védi ki az irrelevancia-csapdát. Az „egyik sem” típus tanítása segíthet (CLINC), de a When2Call-on a rajta tanult modellek közül egyik sem éri el az alapmodellt.
Ez nem a JEV hibája: a kártyája tanár-hűséget és pontosságot mér rögzített opciókészleten, és abban erős. Amin a mi adapterünk elbukott — irrelevancia és szelektív precizitás eloszlásváltás mellett, a kalibrált alapmodellel szemben —, azt a kártya nem méri, és a közzétett eredményeik tették lehetővé, hogy megmérjük.
8. fejezetKiszolgálás: egy példány, több adapter
- Két adapter egy példányon működik. A 2. kör adaptere és az 1. körös cikkbesoroló adapter egyszerre betöltve, soros és párhuzamos (c = 16, vegyes adapteres és adapter nélküli) forgalom mellett is ugyanazt adja, mint az egyadapteres példány: a top-címke-egyezés mind a négy feltételben a két friss egyadapteres példány egymás közti egyezésén belül van (a különbség egyoldali alsó korlátja −0,26 és −0,70 pont közt).
- A LoRA-támogatás bekapcsolása önmagában is változtat. A vLLM 0.30
--enable-loramellett a MoE-réteg FP8-kernelét is cseréli, és ezen futnak a LoRA-t nem kérő kérések is: a bizonytalan döntések ~6 %-a átbillen, a példány újraindításonként más numerikai módba eshet. Kimutatható pontosságromlás nincs (±1,3 pont felbontással). Meglévő forgalommal közös példánynál ezzel számolni kell. - Ár: egy döntés ~160 ms egyesével, párhuzamosan ~15 döntés/s egy GB10-en; a LoRA-kérés többletköltsége 3–10 %.
9. fejezetAmit a mérés közben elrontottunk
- Egy nem kitartott „új szállító” réteg. Az 1. kör generátora a szállítói réteg 14 szállítóját a tanításba is betette. A réteg így „látott szállító, új pár” lett. Egy előre rögzített kiegészítésben 16 valóban új szállítóval újramértük; a +19,5 pont innen jön.
- Plafonon ülő val. Az 1. körben a val olyan könnyű volt, hogy a karválasztás zajra döntött. A 2. körben az előre rögzített szabály szerint plafonon ülő val mellett nem hangoltunk.
- Szinonim opciók a kényszerített „egyik sem” mögött. Az első átnézés 99 itemből 12 hibát talált, zömmel a cikktörzs szemantikus duplikátumait: ha a levett cikk szinonimája a listán maradt, az „egyik sem” hamis volt. A 2. körben a szinonimaszűrés már a generálás előtt futott.
- Gépi címke-átnéző. A 2. kör magyar címkéit egy gépi ágens nézte át; csak a döntések időbélyegéből derült ki, hogy nem ember kattintott. Utólag emberi vak szúrópróbát tettünk rá (2. fejezet).
- Egy hiányos hipotézis. A 2. kör rétegenkénti általánosítási hipotézise a lefedettség-különbséget precizitási feltétel nélkül ítélte meg, ezért mindkét rétegen „általánosít” ítéletet adott, miközben ott az adapter precizitása bukott. Előre rögzített szabály, nem írtuk át; a fő hipotézis bukása miatt nincs rá épülő állítás. A következő körben a rétegítélet precizitáshoz kötött.
10. fejezetA hipotézisek verdiktje
| állítás | verdikt | alap | |
|---|---|---|---|
| 1/H1 | számlasor → cikk: az adapter veri a kalibrált alapmodellt | igazolt | lef@95 +13,7 [4,8; 21,0]; AURC −0,0255 |
| 1/H2 | általánosít új kategóriára és új szállítóra | igazolt | +9,8 [1,7; 15,5]; +19,5 [10,2; 29,2] |
| 1/H3 | ugyanazon a példányon a LoRA nélküli forgalom változatlan | cáfolt | a LoRA-támogatás kernelt vált; ~6 % billenés, romlás nélkül |
| 1/H5 | jobb kalibráció | igazolt | ECE 0,043 → 0,010 |
| 2/H1 | eszközválasztás: az adapter veri a kalibrált alapmodellt | cáfolt | precizitás-bukás (0,83–0,85); AURC az alapmodell javára |
| 2/H2 | általánosít (BFCL-live + When2Call, magyar) | formálisan „általánosít” | a definíció nem köti precizitáshoz (9. fejezet); a 2/H1 nélkül nincs rá épülő állítás |
| 2/H3 | veri a natív tool callingot | igazolt | +3,4 pont precizitás, +7,4 pont lefedettség; az előny zöme a kalibrált kiolvasásé |
| 2/H4 | két adapter egy példányon, párhuzamosan is | igazolt | mind a négy feltétel a zaj-alapon belül |
| 2/H5 | nincs irrelevancia-kompromisszum | cáfolt | X-fedés −8,9 [−11,4; −6,3] |
Az 1. kör H4-e (lineáris szonda a rejtett állapoton: ér valamit, de az adapter alatt marad) és H6-ja (külön döntési fej, nem futott) a teljes protokollban szerepel.
11. fejezetKorlátok
- Egy modell, egy kvantálás, egy motor, egy hardver. Hogy egy másik alapmodell hol gyenge, azt újra kell mérni.
- Az 1. kör szintetikus adaton fut, egy generátorcsaládból; a valós ügyféladaton végzett igazolás külön történik. Az „egyik sem” esetek zöme ott konstrukció.
- Az előny mérete a valós „egyik sem” aránytól függ (1. kör: 25 % X mellett +13,7, 10 %-nál +3,5 pont).
- A 2. kör magyar címkéinek maradék zaja felső korlátban 2,4 %, az előre rögzített 2 %-os kapu fölött.
- A JEV-összevetés eltérő keretben fut (négy válaszmód vs. eszközlista + X), ugyanazokon az itemeken; a JEV-modelleket nem futtattuk, a közzétett valószínűségeikkel számoltunk.
- A mechanizmus-bontások utólagosak (6. fejezet): magyaráznak, ítéletet nem változtatnak.
- A teljesítményszámok egy-egy példányon, egy futásból származnak.
12. fejezetDöntés és ami jön
Az előre rögzített publikálási szabály szerint az 1. kör adaptere és adatkészlete publikus, a 2. köré közül csak az adatkészlet és a mérés: a 2. kör adaptere nem kerül ki. A kitartott teszten a kalibrált alapmodell jobb vagy egyenlő, és aki letöltené, rosszabbul járna vele, mint az alapmodell gondos kiolvasásával. Az eszközválasztáshoz a DocAI-ban a kalibrált kiolvasás megy tovább, adapter nélkül.
A következő kör egy általános magyar döntési adapter sok feladatcsaládon. Abba ez a mérés négy szabályt visz:
- Csak ott tanítunk, ahol az alapmodell gyenge. Ahol a kalibrált alapmodell a plafon közelében van, az a család csak kis arányban kerül a tanításba.
- Az „egyik sem” többféle típusa a tanításban, nem csak kényszerített: természetes megválaszolhatatlan, hatókörön kívüli kérés közeli opciókkal, hiányzó feltétel.
- Horgony az alapmodellhez az „egyik sem” eseteken, mert a hívás/nem hívás szétválasztásában a kalibrált alapmodell volt a legjobb.
- Küszöb a célforgalom eloszlásán, mert a val-on választott küszöb egyik karnál sem vitte át a 95 %-ot egy más típusú tesztre.
A számlasorok cikkhez rendelésében a döntési adapter valódi nyereség: több sor könyvelődik automatikusan, kisebb kockázattal, és a gép tudja, mikor kell emberhez fordulnia. Az eszközválasztásban ugyanez a lépés felesleges, sőt árt: ott a kiszolgált modell gondosan kalibrált valószínűségei a jobb megoldás. A tanulság általánosabb a két feladatnál: finomhangolás előtt meg kell mérni, hol gyenge az alapmodell, és a tanításnak pont azt az „egyik sem” esetet kell mutatnia, amivel élesben találkozik.
MellékletApparátus
1. kör (számlasor → cikk): adapter
Qwen3.6-35B-A3B-invoice-decision-lora,
adatkészlet hu-invoice-catalog-decisions
(Hugging Face; az adapter Apache-2.0, az adatkészlet CC-BY-4.0), a kiszolgálási megjegyzéssel a model cardon.
Mérési csomag (mindkét kör protokollja, kódja, eredménylapjai és itemenkénti
kiolvasásai, a JEV-összevetés, valamint egy ellenőrző szkript, amely a közölt számokat a kiolvasásokból
újraszámolja):
docai-evals → 2026-10-09-decision-lora-where-to-train-gb10.
Protokollok: az előregisztrált runbookok és a naplók (magyarul) ugyanott, a protocol/ alatt.
Külső források:
autotrust/JEV-27B és
jev-decision-index-results
(Apache-2.0); a Decision Index kit (apolinario/decision-index, MIT);
xLAM (APIGen, arXiv:2406.18518), When2Call, BFCL, MASSIVE; a Hammer-cikk (arXiv:2410.04587) az irrelevancia-kompromisszumról.
Rövid változat: a blogon, Hol érdemes tanítani a modellt?